假终端:360M 模型现场编出整个屏幕|听懂AI #069
WorldTUI 把一个 360M 参数的小模型训练成了终端:背后没有 shell、没有文件系统,你每按一个键,它就预测整块屏幕该怎么变。打错 pythoon 它照单全收,208MB 在浏览器里就能跑。本期访谈聊自我修复、333 词元词表,以及应用不再被写出、而是被学出来的未来。
这个终端,背后根本没有终端。没有命令解释器,没有文件系统,你看到的每一行,都是一个 360M 参数的小模型现场编出来的。
这是独立开发者 simedw 的 WorldTUI(HN 608 分),想法来自 DeepMind 的 Genie 3:未来的应用也许不是写出来的,而是学出来的——模型直接预测用户输入之后,世界应该变成什么样。游戏世界太大、算力不够,他把野心缩小到一个终端:不预测像素,只预测一张字符网格里,每个格子该填什么字符。
它的诀窍有三层。第一,视角:把终端看成字符网格,模型要做的不是写代码,是把下一格填对;你每按一个键,它就猜一次整块屏幕该怎么变,连光标落在哪一格都一起算好。第二,训练:在 Docker 里跑真实程序,把"按键→屏幕变化"一对一录下来,攒了 33.6 万段会话、约 20 亿词元,连 1.2% 的打字错误率都模拟——模型学的是人的真实操作。第三,工程:333 个词元的极小词表、滚屏用的 COPY 行操作、逐行并行解码,大屏刷新从 6.7 秒压进 0.87 秒;猜错了还能自己修回来,三轮修正越修越准。
最妙的测试是"穿帮":故意打错一个字母 pythoon,真终端会报错说找不到命令,它却照单全收、继续演——因为它根本没有"命令"这个概念,只有一直演下去的屏幕。它能跑 vim、开 tmux、玩贪吃蛇,量化到 int4 只有 208MB,在浏览器标签页里用 WebGPU 就能跑。今天请来 AI 系统研究员沈知远(世界模型方向),聊聊这块"世界模型的第一块试验田"。
本文由每日自动管线生成:选题与素材来自 Hacker News 公开讨论(HN 608 分 / 181 评论),访谈内容由 AI 基于公开资料整理,嘉宾为角色设定,观点不代表任何真实人物。
小听: 知远,先给没看原文的朋友一句话介绍:WorldTUI 到底是个什么东西?数据是怎么"喂"出来的?总不能靠人一颗一颗按键去录吧?
沈知远: 还真是"录"出来的,只不过录的是机器。作者在隔离的容器里跑真实的程序——敲命令、开 vim、进 Python 交互环境、玩贪吃蛇,把每一次按键和按键之后屏幕的样子成对记下来。最后攒了 33.6 万段会话,大概 20 亿个词元。有意思的是,他还故意让"录制员"犯错:打字错误率设到 1.2%,连 Tab 补全都模拟,这样模型学到的才是人的真实操作,而不是教科书式的完美输入。
小听: 关键设计是把终端当成一张"字符网格",而不是一串文字。为什么这个视角更聪明?直接按像素学不是更通用吗?
沈知远: 像素太贵了。一张终端屏按像素算,一次全屏重绘要生成三千多个词元,慢得没法用。字符网格聪明在三处:第一,终端本来就是字,整个模型的词表只需要 333 个词元——256 个字节字符、64 个行号,加几个特殊操作,词表从 15 万直接砍到 333;第二,他发明了一个"复制行"操作,滚屏时不用重写每一行,一行只要三个词元;第三,解码做了语法约束,模型每次输出都保证是一次合法的屏幕更新,不会吐出乱码。这 333 个词元的词表,后来还帮了大忙——把模型塞进浏览器全靠它。
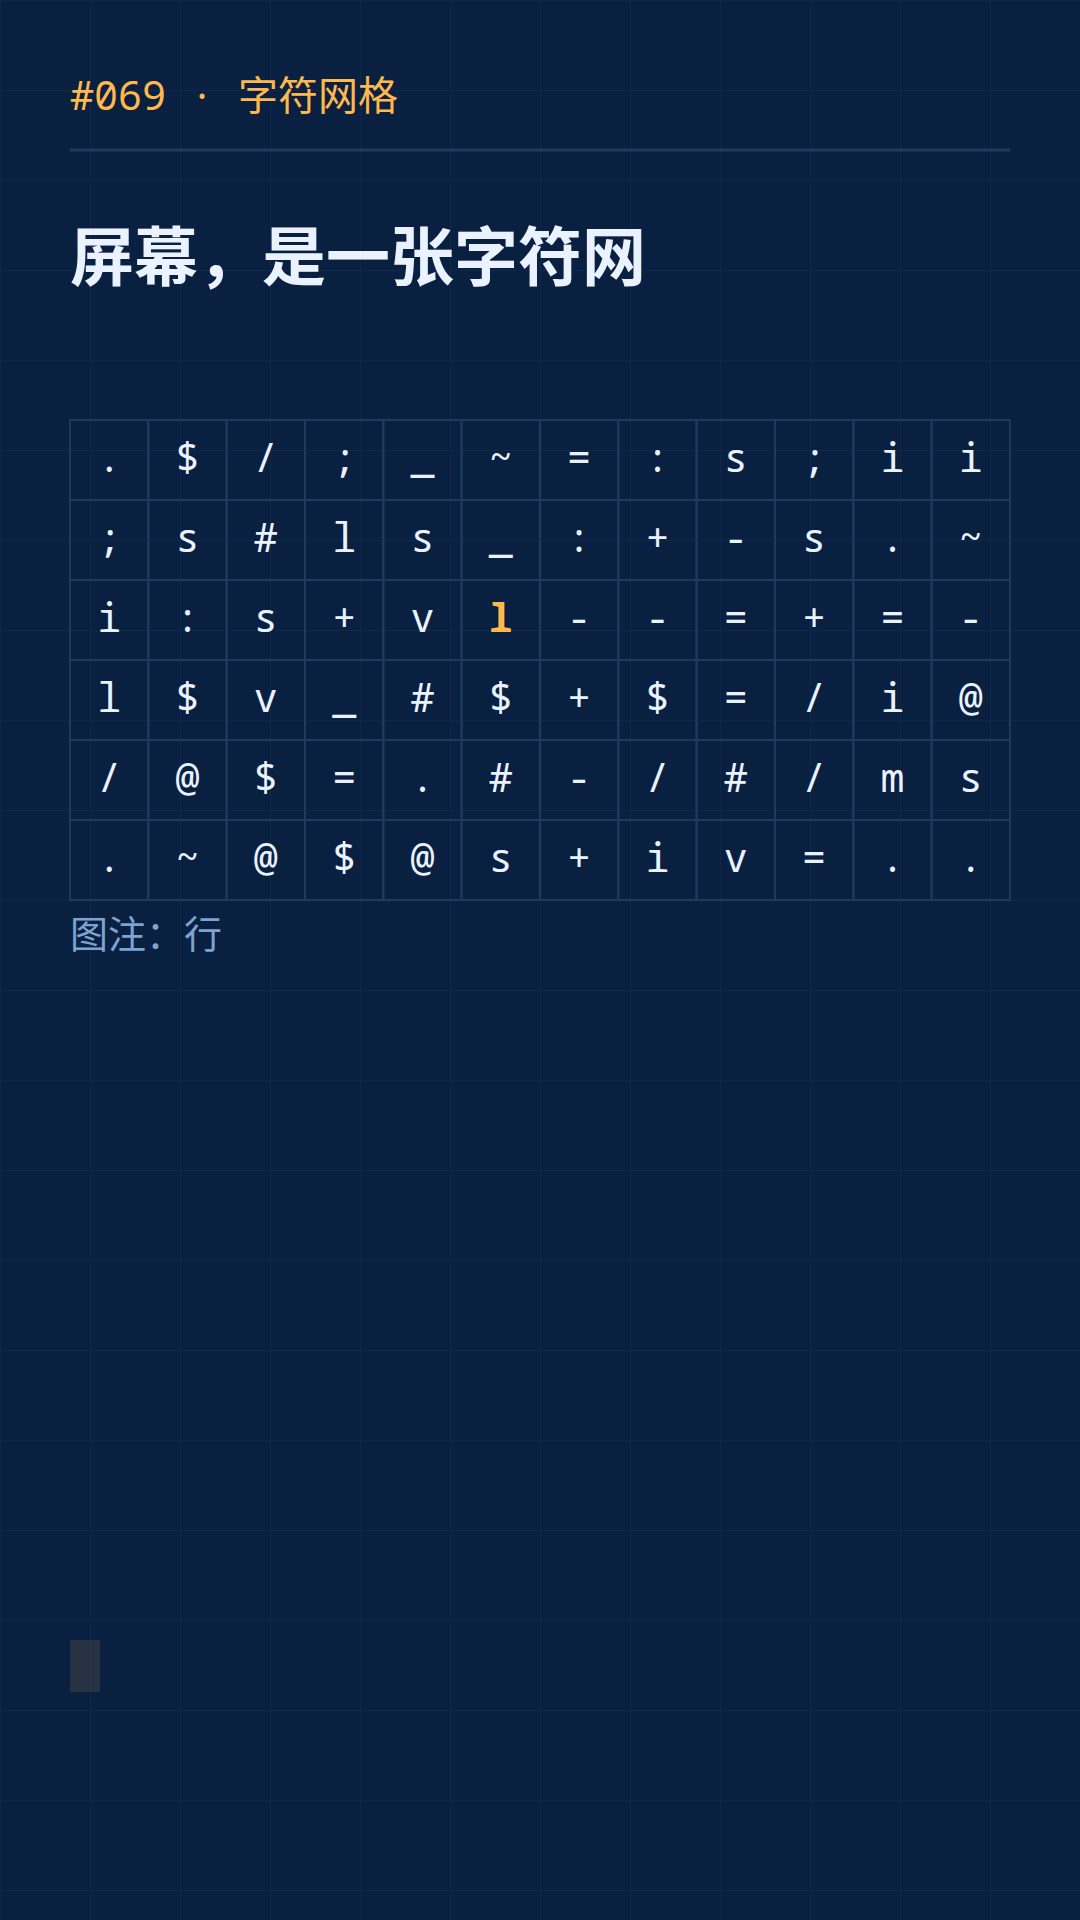
终端不是文本流,是一格一格的世界。
小听: 视频里说它"猜错了还能自己修回来",这怎么学?模型又不知道自己错了。
沈知远: 这是整个项目里我最喜欢的一招,思路来自 DAgger。训练时先让模型自己往前预测几步,再把它的屏幕和真实录制的屏幕对比;如果差得不多,就构造一个"修正动作",教它在下一次按键时把错的地方修回去。本质上是让模型从自己犯过的错里学,而不是只看标准答案。做了三轮,效果很实在:他自己定的 47 个疑难测试从 24 个通过涨到 38 个。但有个铁律——修正里出现的词,必须在之前的真实屏幕或用户输入里出现过,不能是模型自己编的,否则等于在奖励幻觉。
小听: 还有个反常识的发现:他试着把模型蒸馏变小,结果"记忆"说没就没了?
沈知远: 对,非常漂亮的一个实验。只删掉第 7 层、不做任何重训,下一个词元的预测准确率几乎没变,99.3% 掉到 98.9%。但让它"建个文件、过一会儿再读回来"的记忆测试,直接从 64 次全对掉到 0 次全对。后来他发现是第 1、7、15、22 层这四层管记忆,保住它们,16 层的学生模型记忆全对。所以一个模型"看起来会说话"和"真的记得住",可能是两套完全不同的电路。蒸馏最后他放弃了,改走另一条路。
小听: 另一条路就是 208MB 塞进浏览器?这什么概念?
沈知远: 概念就是:现在你打开一个网页,里面跑着一个会"演"终端的世界模型,全程本地,不联网。怎么做到的?先把 15 万词元的嵌入表砍到只剩 333 个,1.36 亿参数直接扔掉,模型从 4.94 亿参数瘦到 3.6 亿;再做 int4 量化,压到 208MB。作者还手写了一套跑在 WebGPU 上的推理代码,用 WGSL 着色器在显卡上解 4 位权重。在他自己的 M4 Mac 上,敲一个字母 60 毫秒,基本跟手。所以世界模型不一定非要数据中心,它可以小到住进一个浏览器标签页。
小听: 那它到底"记住"了多少?真能当个小电脑用吗?
沈知远: 有限,但比你想象的多。最打动作者的一刻是:他开了 tmux,在一个窗口用 vim 改文件、保存,切换到另一个窗口 cat 出来,内容是对的——那一刻他说自己像弗兰肯斯坦,"它活过来了"。环境变量展开、Python 里的小算术也还行。但别指望太多:往文件里追加一行再读出来,经常读不到;目录嵌套深了它会"迷路",突然发现自己在另一个路径。它是个"看起来像终端的世界",不是真的文件系统。
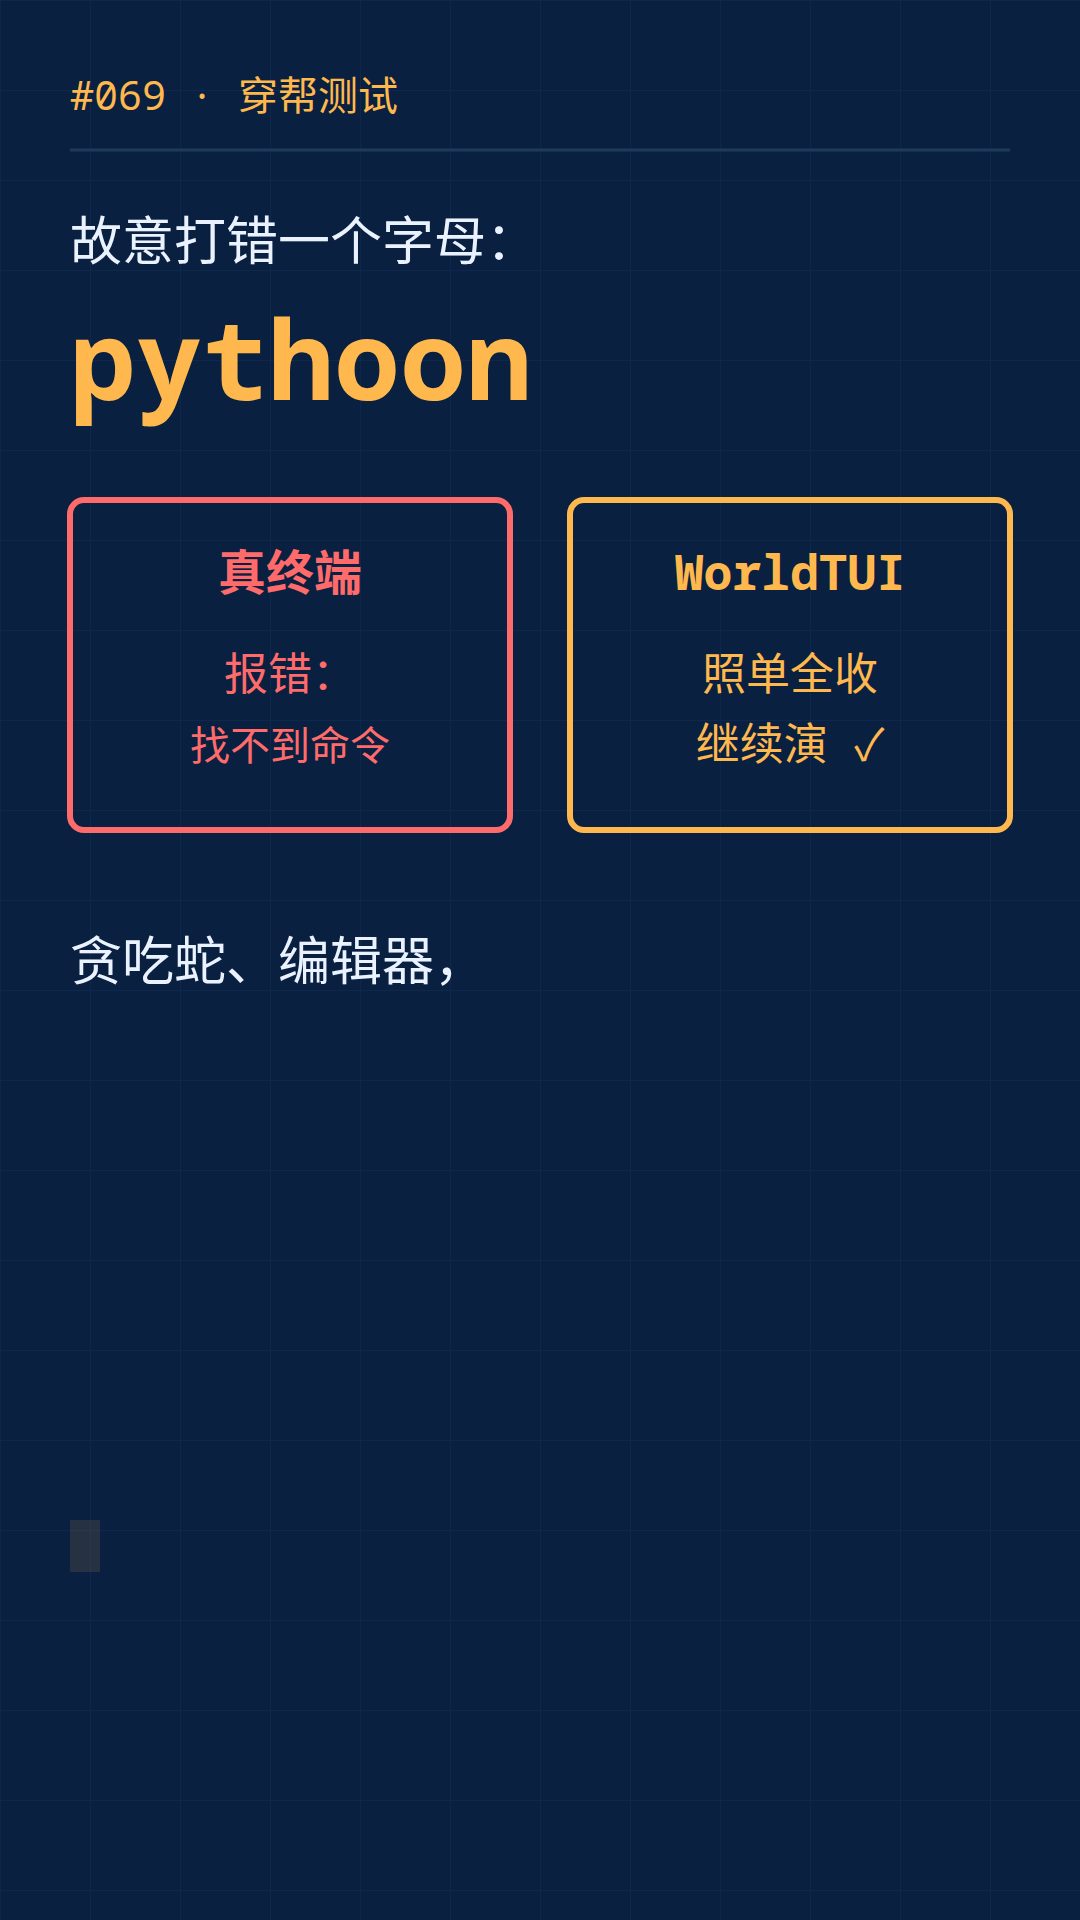
打错一个字母,真终端报错,它却照单全收继续演。
小听: 最后聊聊更大的图景。作者说灵感来自 DeepMind 的 Genie 3,终极想法是"应用不再用代码写,而是学出来"。你怎么看?
沈知远: Genie 3 是"按帧预测游戏世界",WorldTUI 是"按键预测终端世界",路子是一样的:世界模型不实现规则,只学习"输入进来、世界该怎么变"。作者的下一步计划很激进——随机生成几千个从没见过的"假应用",每个有自己的操作规则,看模型能不能光靠上下文线索,预测出一个陌生应用的行为。如果那能成,意味着模型学到的不只是"终端",而是"应用"这个概念本身。当然他也承认,现在的自回归逐行解码还是太慢,未来可能要用扩散解码来生成屏幕。终端只是第一块试验田。
小听: 总结:3.6 亿参数,没有 shell,没有文件系统,靠预测屏幕"演"出一个终端,还能被你打错命令骗过去——啊不,是它骗你。下期见。
参考资料:Simon Edwardsson《WorldTUI: I trained a 360M model to pretend to be a terminal》 · HN 讨论 50190363 · 浏览器试玩 demo