万亿大模型,权重全公开|听懂AI #077
法国公司把自家最大的模型权重全部公开了:参数总量一万亿,每次回答只动用其中的四十九亿。一次能读上百万字、会一百六十多种语言,训练只用了两个月。更关键的是门槛:过去要一屋子机器才能跑的万亿模型,现在四块顶级显卡就能带起来,价格还砍了一半。开源的意义不在参数多大,而在谁都能在自己的机器上真正用起来。
法国 Mistral 公司刚刚把自家最大的模型 Large 4 的权重全部公开了。
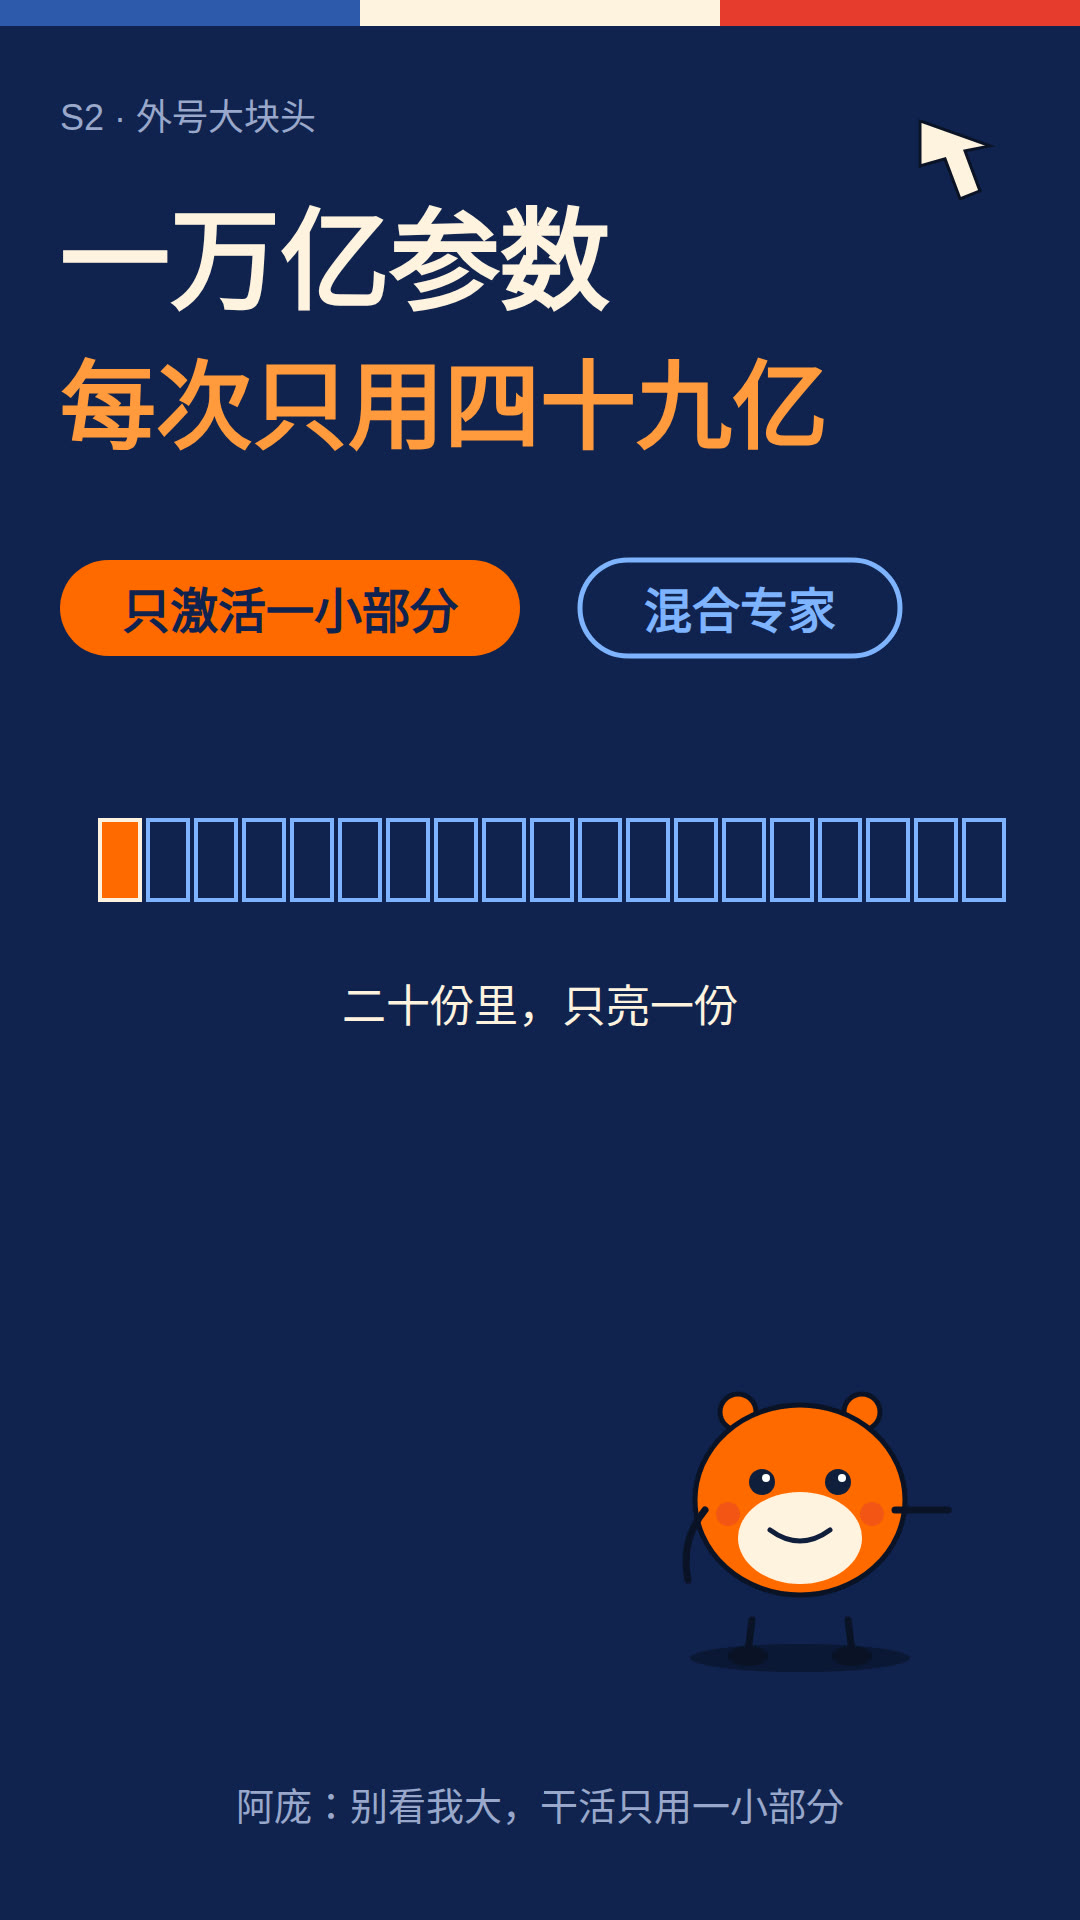
这个模型内部有个外号,叫“大块头”。参数总量一万亿出头,是 Mistral 迄今最大的模型。但它是个稀疏混合专家结构,每次回答其实只动用其中的四十九亿参数,算上嵌入层也就五十二亿左右。体量很大,干活的时候只用一小部分——二十份里,只亮一份。
它一次能处理多少内容?上下文窗口是一百万 token,差不多能一口气读上百万字,整个中型代码库可以一次塞进去。它还是原生的多模态,能看图,支持一百六十多种语言,覆盖了欧盟的全部官方语言,定位就是编程、网络安全、金融、法律这些关键工作负载。
练出这么个大块头,花了多久?按 Mistral 的说法,从零训练只用了大约两个月,三千八百块英伟达 Grace Blackwell 显卡,全在欧洲自己的数据中心里跑完。整个链条是欧洲端到端的,这也是他们一直强调的一点。
十月初它刚发布的时候,还只是个 API 预览。这次权重公开意味着开发者可以把它下载下来,在自己的基础设施上跑,不用把敏感数据送到别人的服务器上。权重已经上了 Hugging Face,提供了 FP8 和 NVFP4 两种量化版本,许可是一个改良的 MIT 式许可,不过模型即服务商需要另外拿商业许可。
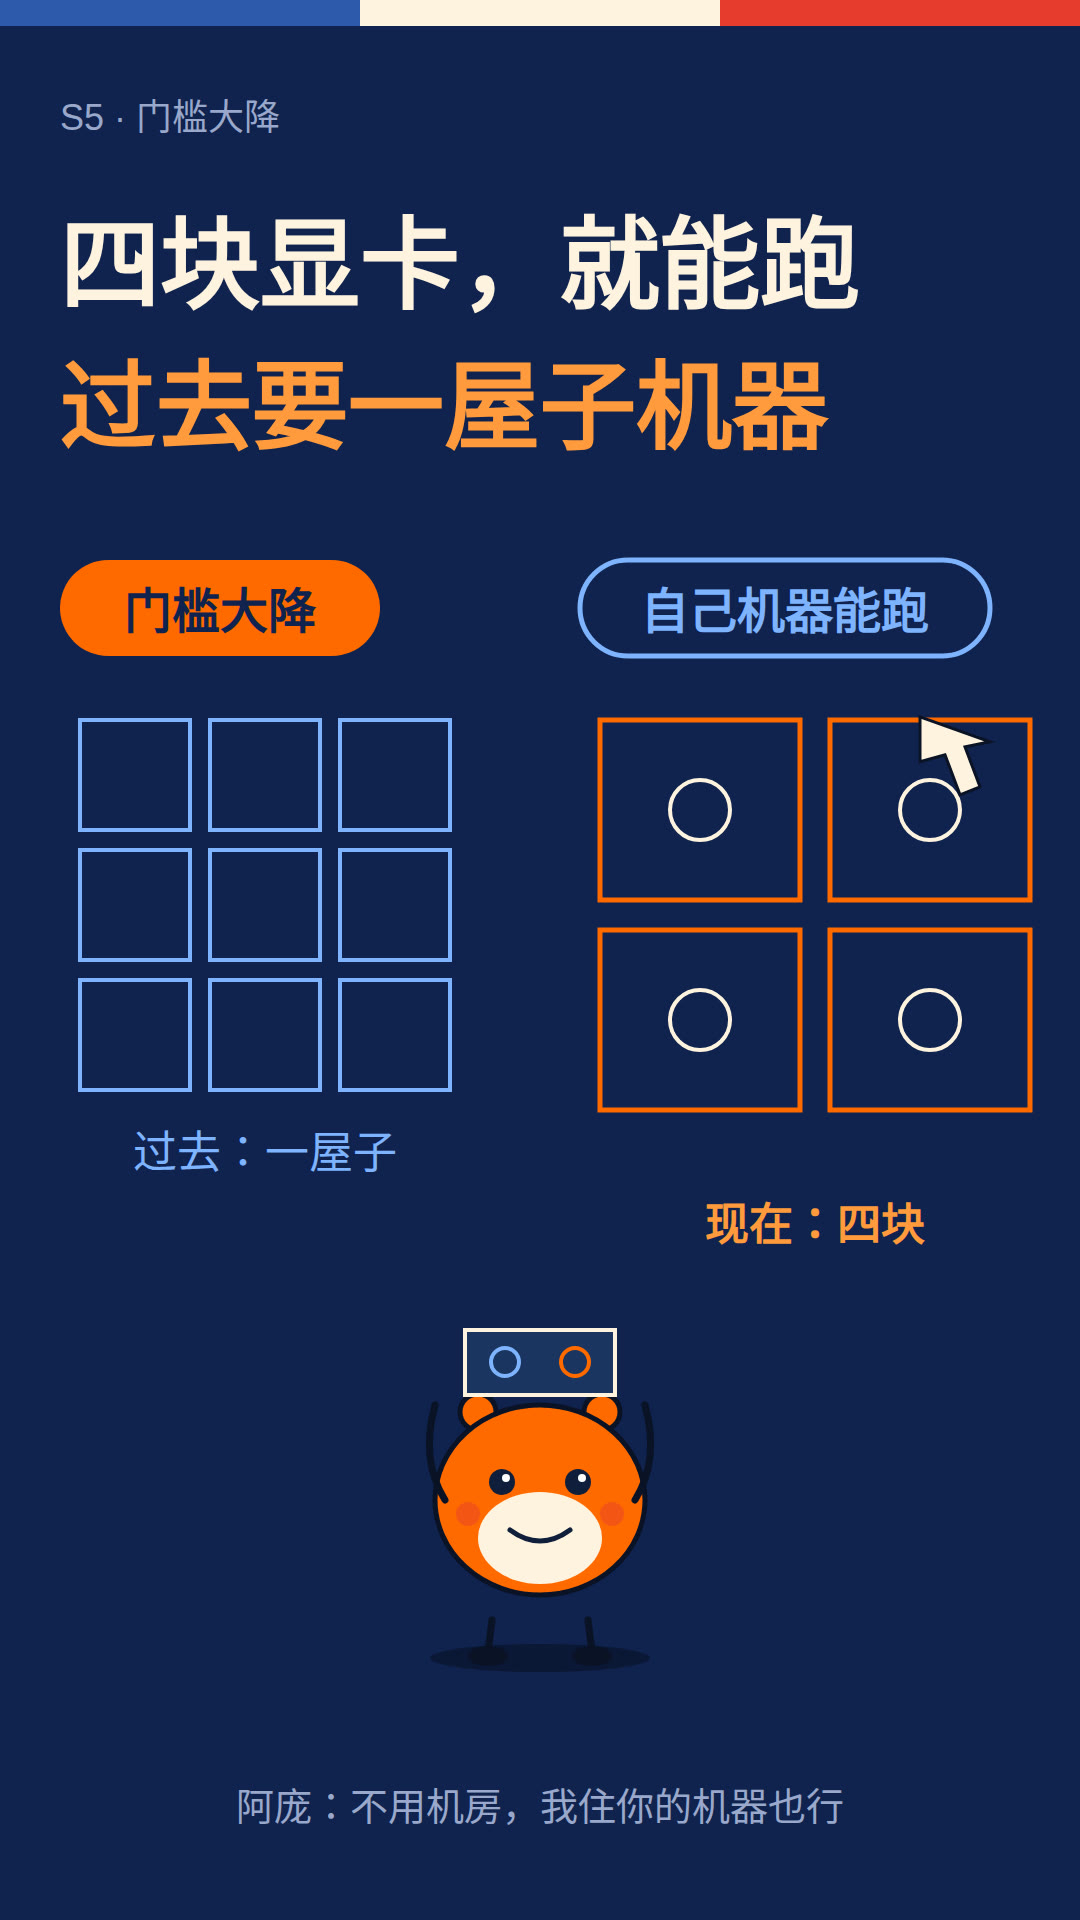
一万亿参数的模型,普通团队真的跑得动吗?按公开的说法,最少四块英伟达 B200 或者 B300 级别的显卡就能带起来。对万亿规模来说,这个门槛已经相当低了。而且 API 价格也跟着砍了一半:输入从每百万 token 一点三六美元降到零点七美元,输出从四点一八美元降到二点一美元。
除了便宜,这次正式版比三周前的预览版还更强:又多做了三周的强化学习,编程测试 Terminal-Bench 4.0 的成绩从百分之二十八涨到了百分之四十一,网络安全测试 CyberGym 也拿到了百分之七十九到八十二的成绩。另外它有低、中、高三档可选的推理级别,而且推理是关不掉的。
记住这一句:开源的意义不在参数有多大,而在门槛被打下来了。以前万亿模型只属于少数几家有大机房的公司,现在权重公开、四块卡能跑、价格砍半,一个团队就能在自己的机器上把它真正用起来。开源权重竞争的下一局,拼的不再是谁的模型更大,而是谁的模型更好用、更便宜。
本文由每日自动管线生成:选题与素材来自 Hacker News 相关讨论与 Mistral 官方发布及公开报道,访谈内容由 AI 基于公开资料整理,嘉宾为角色设定,观点不代表任何真实人物。
小听: 今天聊一个刚公开的大块头:法国 Mistral 公司把自家最大的模型 Large 4 的权重全部放出来了。先说最直观的,这个模型到底有多大?
沈知远: 参数总量一万亿出头,是 Mistral 迄今最大的模型,内部有个外号叫“大块头”。但它是个稀疏混合专家结构,每次回答其实只动用其中的四十九亿参数,算上嵌入层也就五十二亿左右。也就是说,体量很大,干活的时候只用一小部分。
小听: 一万亿参数,听起来就是个机房级别的东西,它一次能处理多少内容?
沈知远: 上下文窗口是一百万 token,差不多能一口气读上百万字,整个中型代码库可以一次塞进去。它还是原生的多模态,能看图,支持一百六十多种语言,覆盖了欧盟的全部官方语言,定位就是编程、网络安全、金融、法律这些关键工作负载。
小听: 练出这么个大块头,花了多久、用了多少机器?
沈知远: 按 Mistral 的说法,从零训练只用了大约两个月,三千八百块英伟达 Grace Blackwell 显卡,全在欧洲自己的数据中心里跑完。这也是他们一直强调的一点:整个链条是欧洲端到端的。
小听: 十月初它刚发布的时候,还只是个 API 预览,这次权重公开到底意味着什么?
沈知远: 意味着开发者可以把它下载下来,在自己的基础设施上跑,不用把敏感数据送到别人的服务器上。权重已经上了 Hugging Face,提供了 FP8 和 NVFP4 两种量化版本,许可是一个改良的 MIT 式许可,也就是 Mistral 生态开源权重许可,不过模型即服务商需要另外拿商业许可。
小听: 一万亿参数的模型,普通团队真的跑得动吗?
沈知远: 按公开的说法,最少四块英伟达 B200 或者 B300 级别的显卡就能带起来。对万亿规模来说,这个门槛已经相当低了。而且 API 价格也跟着砍了一半:输入从每百万 token 一点三六美元降到零点七美元,输出从四点一八美元降到二点一美元。
小听: 除了便宜,这次正式版比三周前的预览版强在哪?
沈知远: 强在又多做了三周的强化学习。编程测试 Terminal-Bench 4.0 的成绩从百分之二十八涨到了百分之四十一,网络安全测试 CyberGym 也拿到了百分之七十九到八十二的成绩。另外它有低、中、高三档可选的推理级别,而且推理是关不掉的,这是它“会思考”的那一面。
小听: 最后一句,这次开源真正的意义是什么?
沈知远: 意义不在参数有多大,而在门槛被打下来了。以前万亿模型只属于少数几家有大机房的公司,现在权重公开、四块卡能跑、价格砍半,一个团队就能在自己的机器上把它真正用起来。开源权重竞争的下一局,拼的不再是谁的模型更大,而是谁的模型更好用、更便宜。
小听: 谢谢沈知远。本期选题来源是 Hacker News 相关讨论与 Mistral 官方发布及公开报道,访谈内容由 AI 基于公开资料整理,嘉宾为角色设定,观点不代表任何真实人物。