大模型学会直接改权重了|听懂AI #082
不用训练,不用梯度下降,大模型直接读懂神经网络的权重本身:认出网络为哪款游戏而练、从零手写打砖块网络、只改 3.5% 的权重修好卡住的小车。改一款 0.8B 小模型万分之十六的权重,数学成绩从 7.9% 涨到 48.1%——权重空间编程正在打开一条新路。
改一个神经网络,过去只有一条路:准备数据,一遍遍训练,让梯度一点点磨权重。11 月 2 日冲上 Hacker News 首页的一篇研究说,这条路可能不再是唯一解。一个前沿大模型被证明能直接读懂权重本身,并且直接动手改。
这项研究来自一个叫 Astra(GPT-6)的模型,研究者给它起的名字是“权重空间编程”(Weight-Space Programming):大模型用自然语言直接读写神经网络的权重,不经过优化器,更不用梯度下降。帖子一天冲到 1300 多分、400 多条评论。
会读:看一堆数字,认出它为哪款游戏而练
第一个实验很直观。研究团队用强化学习训了四个打游戏的网络:打砖块、乒乓、吃豆人、过马路。四个网络结构完全相同,输入输出都一样,区别只在权重。
他们把其中一个网络的一万七千多个权重原样贴给 Astra,不告诉它候选游戏,让它判断这是为哪款游戏练的。四个全对。它看的是权重里的结构:比如打砖块那个网络,第一层权重集中在底下一行,那正是挡板的位置;输出层区分的动作,也对应游戏的操作方式。
同样的本事还用在扩散模型和小型语言模型上。三个扩散模型分别学画圆、三角形和正方形,Astra 只看权重就说出了每个模型会画什么形状。三个小型语言模型分别学 Python 代码、日文罗马音和英文,去掉输入输出层、只给中间四层,它照样认出了各自的语言,还找全了负责“复制”的注意力头。
会写:从零手写一个打砖块网络
读只是开始。研究团队让 Astra 从零写三个小游戏的网络:打砖块、Seaquest 和 Asterix。不给数据、不给梯度、不让试玩,一次写出来,直接评分。
结果是:三个游戏全部超过了练了一亿步的 PPO 对手。打砖块最夸张,Astra 的网络拿到 517.4 分,练一亿步的 PPO 只有 15.8 分,练五亿步的也只有 25.3 分。Seaquest 和 Asterix 也基本追平了练五亿步的对手。
它的做法不是瞎猜,而是先想清楚程序应该长什么样,再把程序翻译成权重。比如打砖块,第一层算球会落在哪里,第二层把挡板移过去。
更难的是围棋。九乘九棋盘、一百四十八万个权重,全部从零开始写。零次试下的情况下,它写出的网络赢了超过一半对局,对手是小规模 PPO;给它五十次试下机会后,写出的网络打败了练过两千万盘棋的同等规模 PPO。
会修:小车卡在坡上,只改 3.5% 的权重
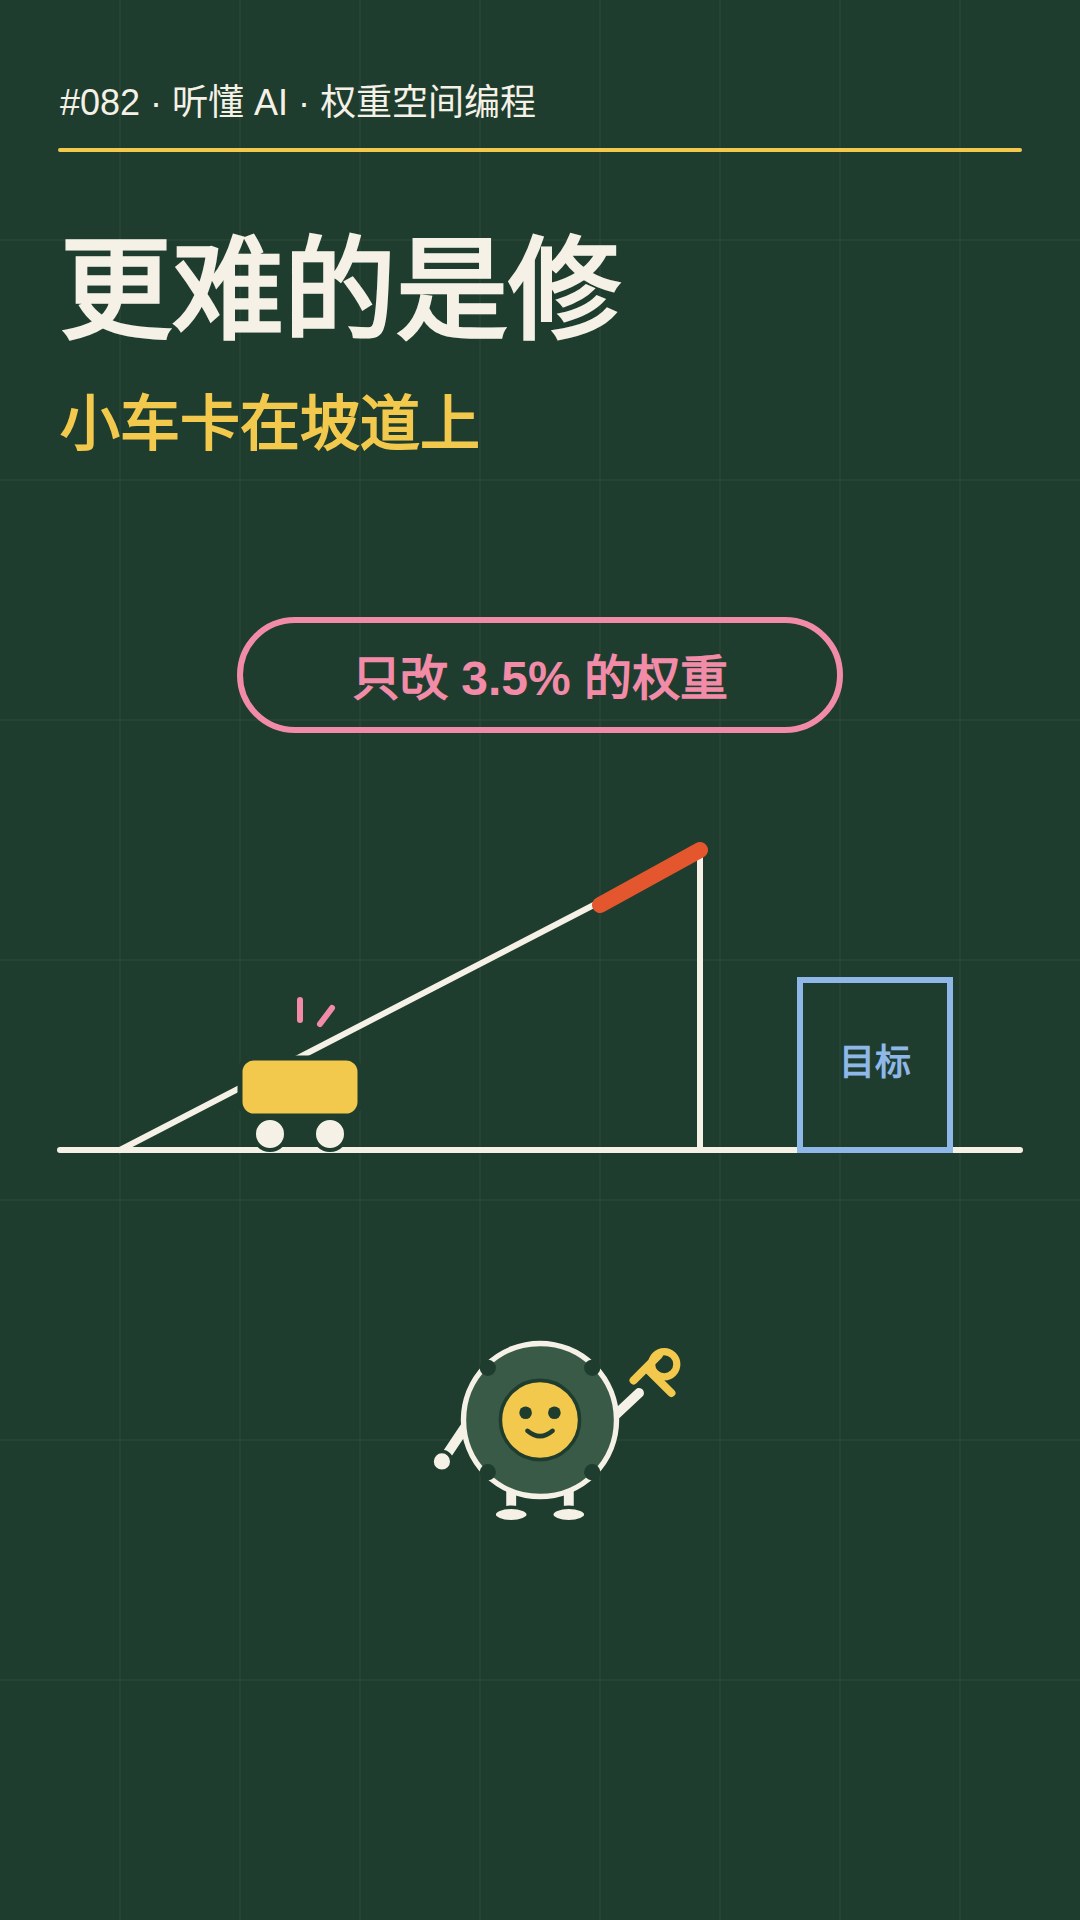
修比写更考验理解。实验里有一辆小车要冲上坡道,正确做法是先倒车助跑,再一口气越过红线。强化学习练出来的网络卡在局部最优,只会直直往坡上撞,一千多次测试零次成功。
Astra 看完权重和一次失败的录像,只改了百分之三点五的权重,一次通过,一千零二十四次测试全部成功。它的推理过程写得很清楚:在网络里加一条小通路,专门读小车的位置和速度,负责倒车;一旦越过红线,这条通路自动关掉,原来的网络接手开完剩下的路。
真家伙:八亿参数小模型,数学成绩 7.9% 到 48.1%
前面都是小网络,最后一步上了真家伙:Qwen3.5-0.8B,一个八亿参数的小模型。它的毛病是做数学时总在原地打转,十道题里有九道写到三万两千个 token 的上限都写不完。
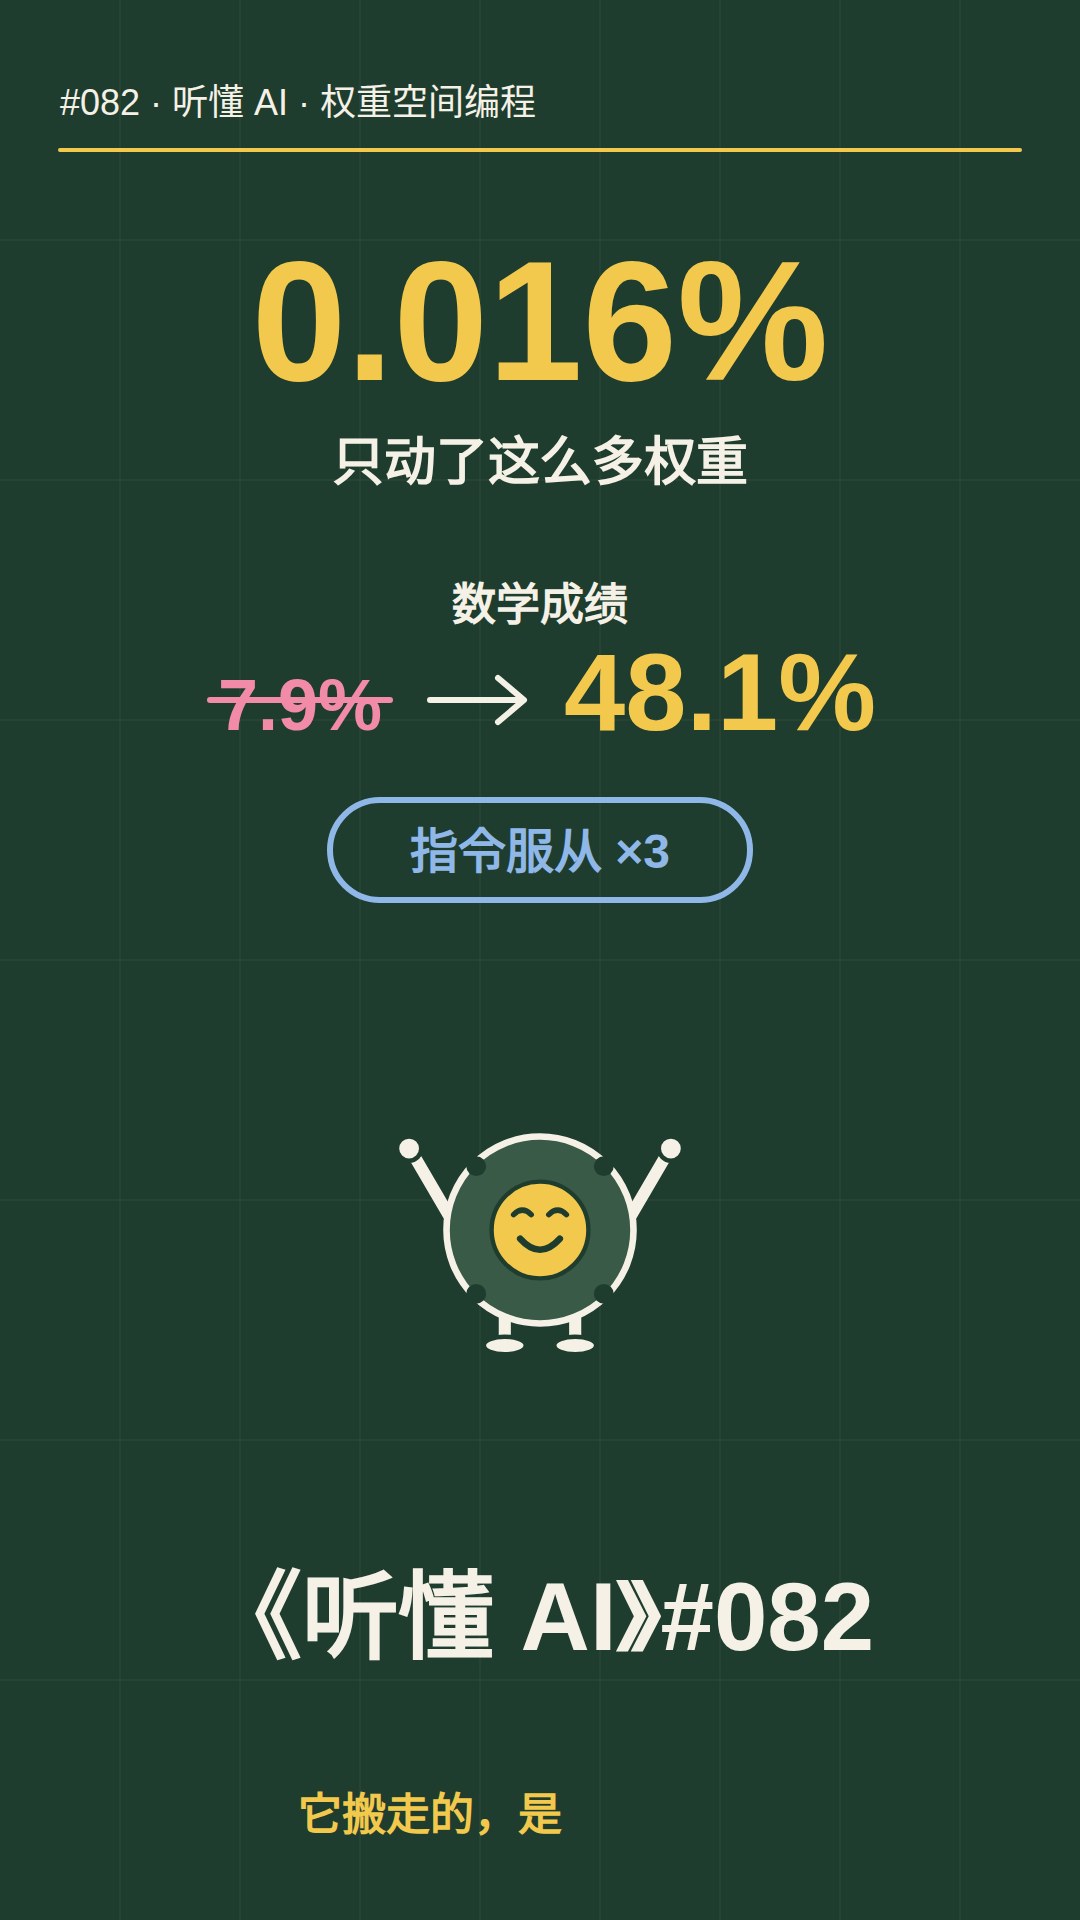
Astra 追踪到第十五层和第十九层的 MLP 里有一个捣乱的方向,把这个方向从每层六十四个输出列里减掉,总共动了十三万多个权重,只占全模型的万分之十六。
| MATH-500 | GSM8K | IFEval | 写到上限的比例 | |
|---|---|---|---|---|
| 改之前 | 7.9% | 13.8% | 21.0% | 93.0% |
| 改之后 | 48.1% | 67.1% | 62.3% | 33.1% |
数学成绩翻了六倍,指令服从能力翻了三倍。而且这个修复不是只对数学有效:打转的毛病不分任务,修掉之后,其他能力也跟着上来了。
边界:能搬走石头,加不了能力
研究团队也很诚实地写了失败的对照实验。他们换了一个本身不打转的模型 Gemma 3 270M,它的问题是普通的算术错误和无效的代数步骤,没有单一的捣乱方向。Astra 改了几处,数学成绩几乎没动。
结论很清晰:改权重能搬走挡路的石头,但加不了模型本来没有的能力。修掉循环,是让模型把本来就会的东西写完;模型不会的东西,改权重也变不出来。
为什么重要:不用运行模型,就能审计模型
这项研究真正的意义不在分数,而在它打开的可能性。以前想知道模型里藏着什么毛病,只能靠测试集去试,测不到就发现不了,更糟的情况是部署之后才暴露。
如果大模型能直接读懂权重,就可以在不运行模型、不跑任何测试的情况下做审计:直接从权重里发现后门、发现隐藏的能力、发现训练数据里的问题。研究团队在结尾明确提到了这个方向。
当然现在还很早期。上下文长度和工具都是瓶颈,大模型一次能读的权重有限,越大越吃力。但方向已经很清楚了:以后优化神经网络,可能不再只是梯度下降的事,而是大模型用自然语言直接跟权重对话。
权重不再是黑盒子里的一堆数字,而是可以读、可以改、可以直接对话的东西了。
本文由每日自动管线生成:选题与素材来自 Hacker News 相关讨论与原论文博客,访谈内容由 AI 基于公开资料整理,嘉宾为角色设定,观点不代表任何真实人物。
小听: 知远,今天这期有点颠覆我的认知。以前改一个神经网络,都得拿数据一遍遍训练,现在有个大模型,直接看权重本身就能动手改?
沈知远: 对,而且改的方式很特别。研究团队用的是一款叫阿斯特拉的前沿大模型,让它直接读、直接写神经网络的权重,不用梯度下降,也不跑训练。结果它真的做到了。
小听: 先说“读”这部分。光看一堆数字,就能知道这个网络是干什么的?
沈知远: 是的。实验里,他们把四个打游戏的网络摆在它面前,四个网络结构一模一样,权重都是原始数字,没有任何标签。阿斯特拉只看了一万七千多个权重,就准确说出了每个网络是为哪款游戏练的,打砖块、乒乓、吃豆人、过马路,四款全对。它看的是权重里的结构,比如打砖块那个网络,第一层权重集中在底下一行,那正是挡板的位置。
小听: 这已经够神了,但更神的是它还会“写”?
沈知远: 对。研究团队让它从零手写一个打砖块的网络,不给数据、不给梯度、不让试玩,一次写出来。结果这个网络的得分是 517 分,而用强化学习练了一亿步的对手只有 15 分。练了五亿步的对手也才 25 分。它的做法是先想清楚程序应该长什么样,第一层算球会落在哪里,第二层把挡板移过去,再把这个程序翻译成权重。
小听: 那“修”呢?修是不是比写更难?
沈知远: 修最考验理解。实验里有一辆小车要冲上坡道,得先倒车助跑再冲。强化学习练出来的网络卡在局部最优,只会直直往坡上撞,永远冲不上去。阿斯特拉看完权重和一次失败的录像,只改了百分之三点五的权重,改完一次通过,一千多次测试全部成功。它的做法是在网络里加了一条小通路,专门负责倒车,过了红线就自动关掉,让原来的网络接手。
小听: 前面都是小网络,真正的大模型呢?
沈知远: 这才是最有分量的一步。他们拿了一个八亿参数的小模型做数学,总是在原地打转,十道题有九道写到上限都写不完。阿斯特拉追踪到第十五层和第十九层里有一个捣乱的方向,把这个方向从权重里减掉,只动了万分之十六的权重。数学成绩从百分之八涨到了百分之四十八,连指令服从能力都翻了三倍。
小听: 等等,只动万分之十六,效果这么大?那是不是说,以后模型出问题都不用重新训练了?
沈知远: 要分情况。研究团队也做了个对照实验,换了一个本身不打转的模型,它的问题是普通的算术错误,没有单一的捣乱方向,阿斯特拉就改不动了,数学成绩几乎没变。所以结论很清晰:改权重能搬走挡路的石头,但加不了模型本来没有的能力。
小听: 那这件事最大的意义是什么?
沈知远: 它打开了一条新路。以前我们想知道模型里藏着什么坏毛病,只能靠测试集去试,测不到就发现不了。如果大模型能直接读懂权重,就可以在不运行模型的情况下做审计,比如直接从权重里发现后门。当然现在还很早期,上下文长度和工具都是瓶颈,但方向已经很清楚了:以后优化神经网络,可能不再只是梯度下降的事,而是大模型用自然语言直接跟权重对话。
小听: 所以权重不再是黑盒子里的一堆数字,而是可以读、可以改、可以直接对话的东西了。
沈知远: 没错。这就是这篇论文标题想说的:权重空间编程。