不用出声就能打字:这副眼镜读懂了你的嘴型
两个乔治亚理工的学生做了副智能眼镜:不用出声,光动嘴型就能把话变成文字,速度和正常说话差不多,帖子冲上 HN 首页、500 多分近 300 条评论。背后是从肌电贴片到射频感知的两次转向,和一场拿数据硬砸出来的跨用户泛化,本期请语音交互工程师周默声聊聊它靠不靠谱。
语音输入有个老毛病:好用,但只能在没人的地方用。在图书馆、办公室、地铁上对着电脑说话,社死程度不亚于外放刷短视频。这个问题最近有人换了个思路解决:话照说,但不出声。11 月 2 日,一家叫 Subvocal 的创业公司带着一副智能眼镜登上 Hacker News 首页——戴上它,默默动嘴型,话就直接变成了文字,速度和正常说话差不多,帖子冲到 500 多分、近 300 条评论。我请来老朋友周默声——他做过多年语音识别的声学模型,现在关注可穿戴输入设备,聊聊这副眼镜到底靠不靠谱,以及它背后那条不太寻常的技术路线。
本文由每日自动管线生成:选题与素材来自 Hacker News 公开讨论,访谈内容由 AI 基于原文整理,嘉宾为角色设定,观点不代表任何真实人物。
小听: 默声,先把最抓人的部分说清楚:这眼镜到底怎么“听”到你没说出口的话?
周默声: 关键不在耳朵,在嘴。眼镜框里嵌着天线,持续向你的脸发射无线电波——强度和蓝牙差不多。这些电波穿过面部,经过舌头、嘴唇、软腭的时候会被你默念的口型动作调制,产生细微的扰动。团队训练的基础模型就是读这些扰动,把它解码成文字。换句话说,它读的不是声音,是发音器官的运动轨迹。
小听: 听起来像科幻,但这条路其实有学术前身。MIT 媒体实验室几年前就做过一个叫 AlterEgo 的静默语音系统,也是这个思路吧?
周默声: 对,源头就是 AlterEgo。Subvocal 的两个创始人 Aarush 和 Arnav,今年年初还是乔治亚理工的计算机系学生,本身是 Wispr Flow 这类语音输入工具的重度用户。他们真正的痛点很具体:在图书馆没法用语音工具。今年二月斯坦福 TreeHacks 黑客松上,两人决定用 36 小时复刻一个 AlterEgo——把肌电电极贴在脸上,读面部肌肉的电信号。原型只做到字母级别,比赛也没赢,但第一次“没人察觉地打出一句话”时,他们觉得这事成了。
小听: 但肌电这条路他们很快就放弃了。评论区有人问为什么,创始人的回答很实在:汗水会改变信号、电磁干扰、每次贴的位置不一样——最重要的是,没人愿意把电极贴在脸上。
周默声: 这是典型的“实验室里成立、产品上不成立”。肌电信号本身没问题,但它对佩戴条件太敏感了,一个出汗、一次贴歪,模型就得重标定。做消费级产品,传感方式首先得对用户零负担。于是他们转向射频:电波穿透面部,不接触皮肤,佩戴体验就是一副普通眼镜。这个转向很关键——它把问题从“怎么贴得更准”变成了“怎么从更弱的信号里解码”,而后者恰好是机器学习最擅长的事。
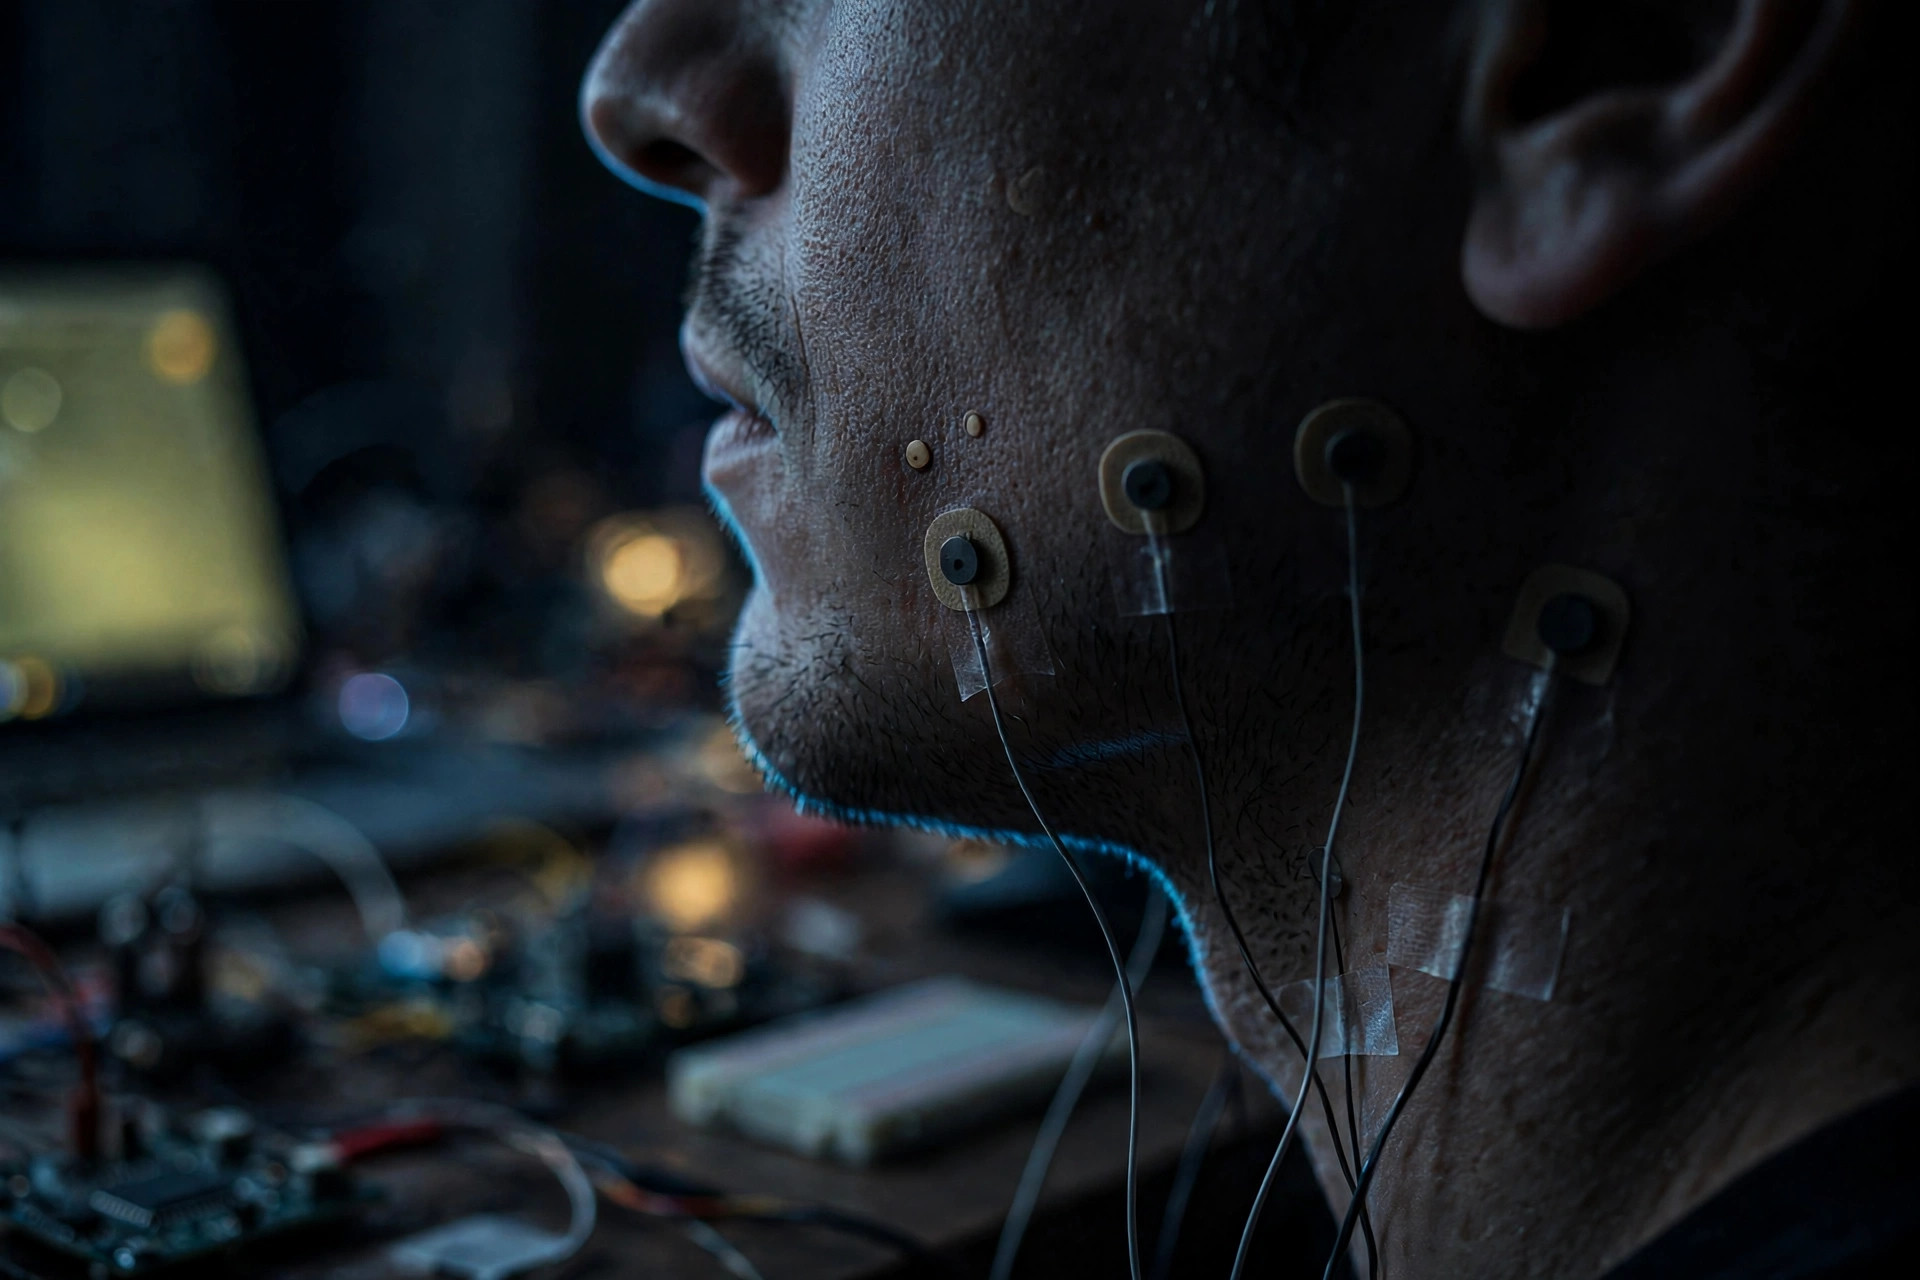
电极贴脸的方案死在佩戴体验上,而不是死在信号上。
小听: 但射频这条路一开始也不顺利。他们的第一版眼镜完全失败,又退回去把天线胶带粘在脸上,甚至做了个固定天线的头架——这段经历在帖子里写得特别坦白。
周默声: 而且这正是最值得聊的部分。他们说自己一开始想自上而下地解决问题,彻底失败了;只有把天线、电路、机器学习每个部件拆到最底层、逐个理解透,才真正做出来。先是搭出极低噪声的射频传感堆栈,再调天线位置,让电磁场和发音器官最大程度重叠。胶带和头架那个阶段,本质上是在控制变量:天线位置和角度固定了,信号才稳定,才知道问题出在哪。最后再用仿真设计出能把天线嵌进镜框的眼镜。这是一条很“硬件”的路:先有信号,再谈模型。
小听: 信号有了之后,真正的硬仗是跨用户泛化。每个人的面部结构不一样,射频信号的模式天差地别,算法上的小修小补不管用。
周默声: 他们的结论很干脆:唯一的杠杆就是大规模扩大预训练数据。他们在办公室摆摊,付钱请人戴着眼镜读提示词,硬生生攒出一条漂亮的缩放曲线——数据量上去,错误率快速下降,跨用户表现开始真正可用。演示视频里 YC 的 Dave 只做了 20 句校准就能用,就是这条曲线的产物。这其实是现在很多 AI 硬件的共同答案:传感问题最后都收敛成数据问题。
小听: 还有个细节很有意思:其实不用张嘴、不用动嘴唇也能用。因为射频能“看”到嘴巴内部,系统可以针对“闭嘴默念”做微调——更像是闭着嘴动嘴型。创始人说练一练就能掌握。
周默声: 这点把想象空间打开了。评论区马上有人接:要是能做到只靠舌头的微小动作,那几乎就是“想”一下就能输入。但也别急着乐观:闭嘴默念需要练习,说明它现在还不是零学习成本的输入方式。而且 20 句校准背后,是每个人都要过一遍的适配流程——这对大规模铺开是个隐形成本。
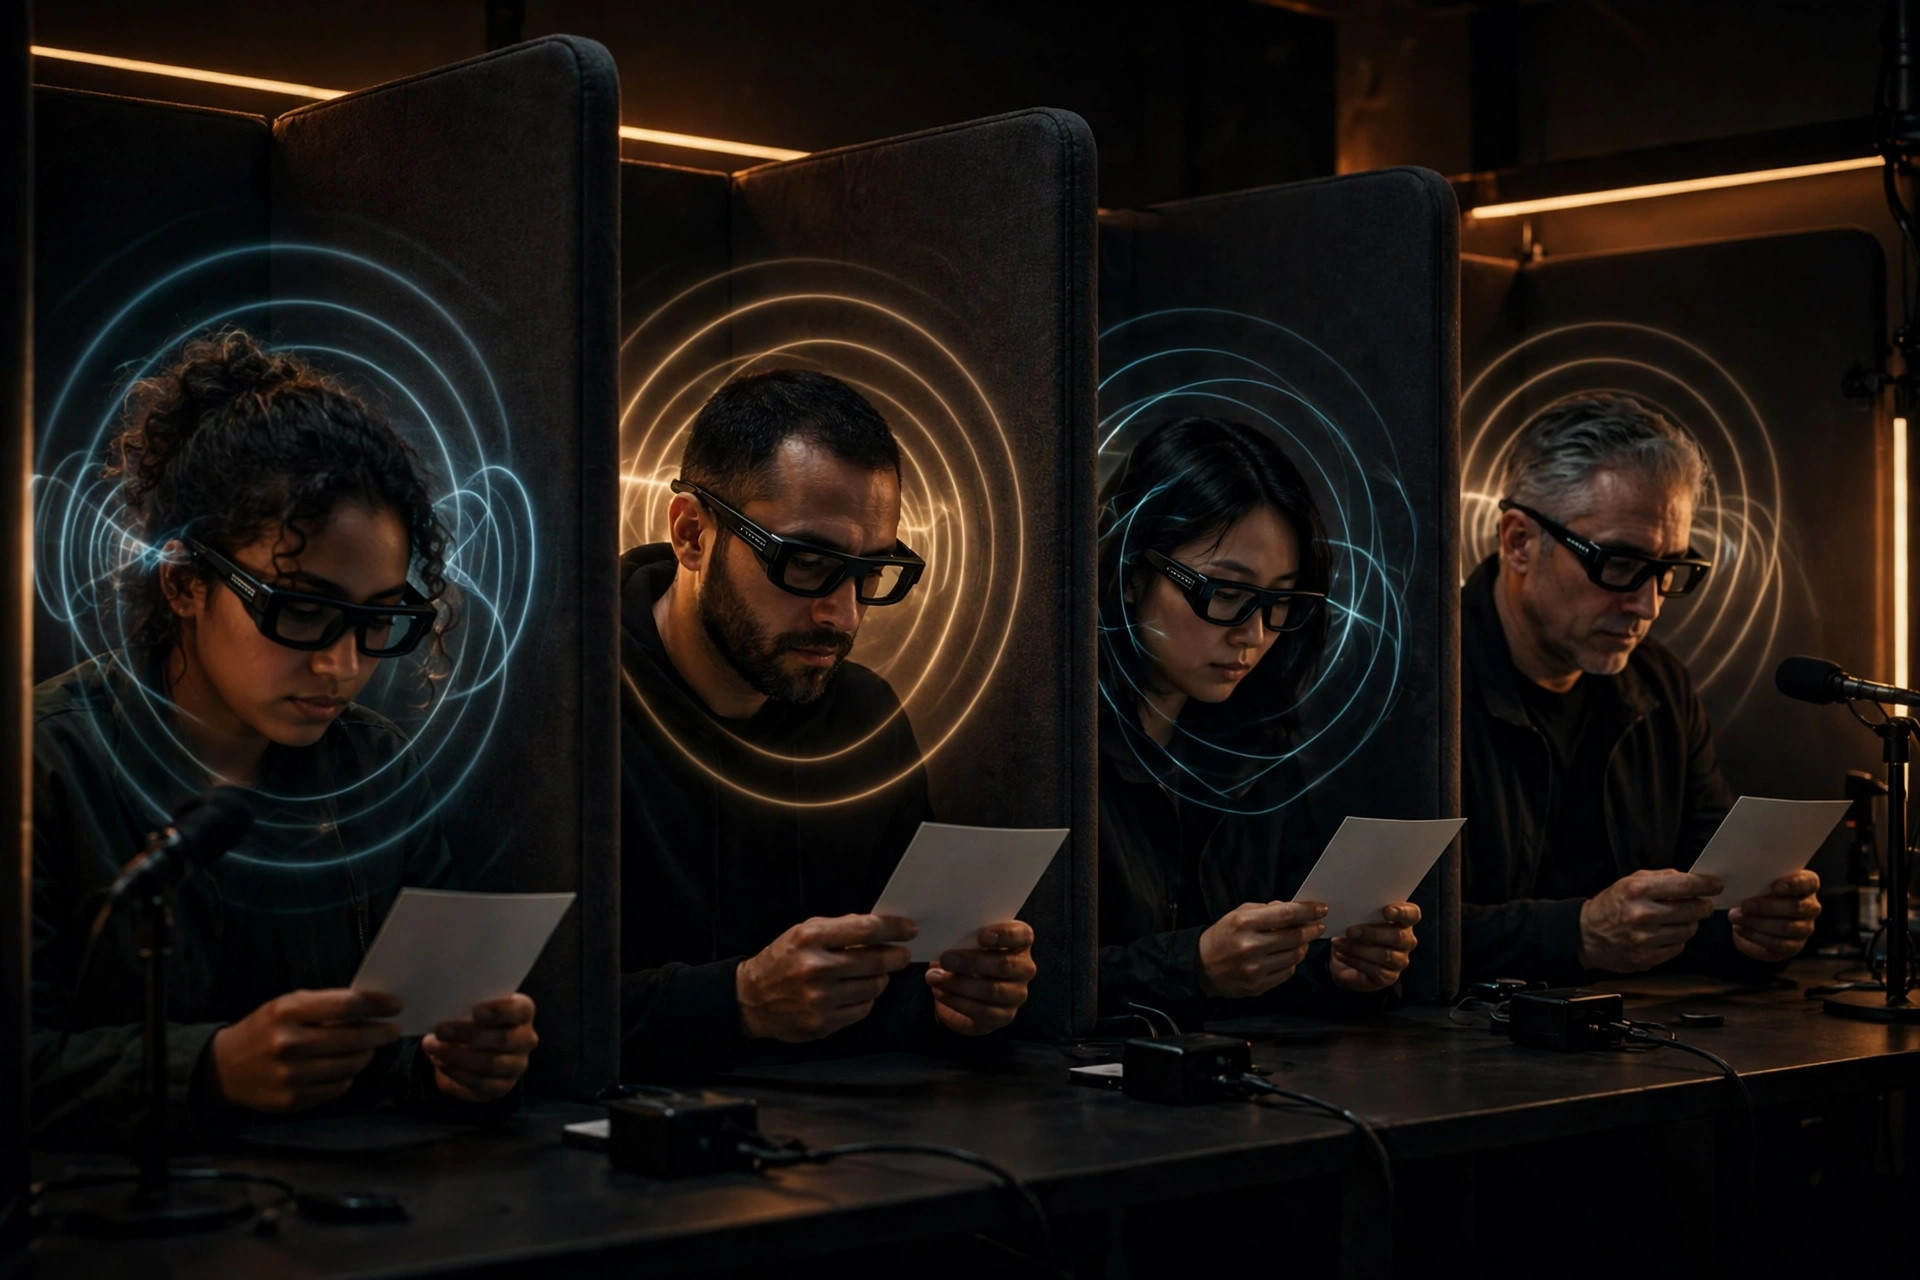
跨用户泛化没有捷径:请人戴着眼镜一句句读,数据量是唯一的杠杆。
小听: 评论区最热的几条质疑也值得摊开说。第一条是隐私:如果射频能读嘴型,远程发射器和接收器能不能偷听别人低声说的话?
周默声: 这是这类技术绕不开的问题。创始人没有正面回答远程窃听的可能性,但从原理上说,信号强度随距离急剧衰减,贴脸天线和远处窃听是两个量级的事。不过质疑本身有价值:任何能“看穿”身体的传感技术,一旦小型化、廉价化,滥用的想象空间就会立刻出现。产品上市之前,这个问题会被反复问到。
小听: 第二条是形态:为什么非得是眼镜?有人问能不能把硬件装在笔记本屏幕上方或者桌面支架上。
周默声: 眼镜的真正作用是提供一个相对面部固定的安装点——天线和发音器官的相对位置必须稳定。笔记本方案理论上可行,但人一动,标定就丢了。眼镜是目前最自然的“随身固定架”。当然代价也很明显:不戴眼镜的人要为此多戴一副东西,这会筛掉一大批潜在用户。
小听: 第三条最直接,有人说这是过度工程:“打字慢就练打字,人能练到很快。”你怎么看?
周默声: 这话对了一半。键盘确实是效率最高的通用输入,但它有个前提:你得坐着、双手空着。语音输入的真正场景是手被占住、或者不方便打字的时候——走路、做饭、开车,或者像创始人说的,在图书馆里。Subvocal 赌的是“随时随地的语音输入”这个场景真实存在。至于赌不赌得成,要看它能不能做到戴上就用、不用练习、识别率稳定。团队说首批 500 台预售,2027 年第一季度发货,200 美元优惠——到时候真实用户的反馈才是裁判。
小听: 最后一问:如果这东西真做成了,你觉得它最大的意义是什么?
周默声: 不是取代键盘,而是给“说话”这件事补上最后一块拼图:有声说话、无声说话,终于都能变成文字。语音助手喊了这么多年“随时随地”,其实一直有个前提——周围没人。一旦静默输入可用,语音交互才真正摆脱了场合限制。从 AlterEgo 的实验室原型,到黑客松上的电极贴片,再到嵌进镜框的天线,这条路走了快十年,Subvocal 只是把它第一次推到了“像个产品”的位置。能不能走完最后一步,看发货。
参考链接
- Subvocal 官网:https://subvocal.company/
- 演示视频(YC 的 Dave 试用):https://www.youtube.com/watch?v=9QdX1eObVYI
- Hacker News 讨论:https://news.ycombinator.com/item?id=50340088