给几亿人回消息的引擎,开源了:DeepSeek 的 DeepInfer
DeepSeek 把自家线上服务一直在用的推理引擎 DeepInfer 开源了,Apache 2.0 许可证,登上 Hacker News 热榜第一,1845 分。相当于一家餐厅把后厨的整套流水线图纸贴在了门口。今天请来推理系统工程师沈知远,拆一拆这台引擎为什么快、又留了哪一手。
DeepSeek 把自家线上服务一直在用的推理引擎 DeepInfer 开源了,Apache 2.0 许可证,登上 Hacker News 热榜第一,1845 分。相当于一家餐厅把后厨的整套流水线图纸贴在了门口。今天请来推理系统工程师沈知远,拆一拆这台引擎为什么快、又留了哪一手。
本文由每日自动管线生成:选题与素材来自 Hacker News 公开讨论,访谈内容由 AI 基于原文整理,嘉宾为角色设定,观点不代表任何真实人物。
小听: 知远,先一句话:这期 HN 1845 分的帖子,讲了个什么事?
沈知远: DeepSeek 把线上服务同款的推理引擎 DeepInfer 开源了。它干的活,是把训练好的大模型,变成你手机上秒回的答案——几亿次请求,全靠这台引擎扛。
小听: 它凭什么快?先说第一招。
沈知远: 异步调度。一般引擎是 CPU 先把一批请求排好队,GPU 再开算,排队时 GPU 闲着。DeepInfer 把排队和计算重叠起来:GPU 算第 N 批时,CPU 已经在排第 N+1 批。官方叫它零开销批调度,GPU 的等待时间被压到接近零。
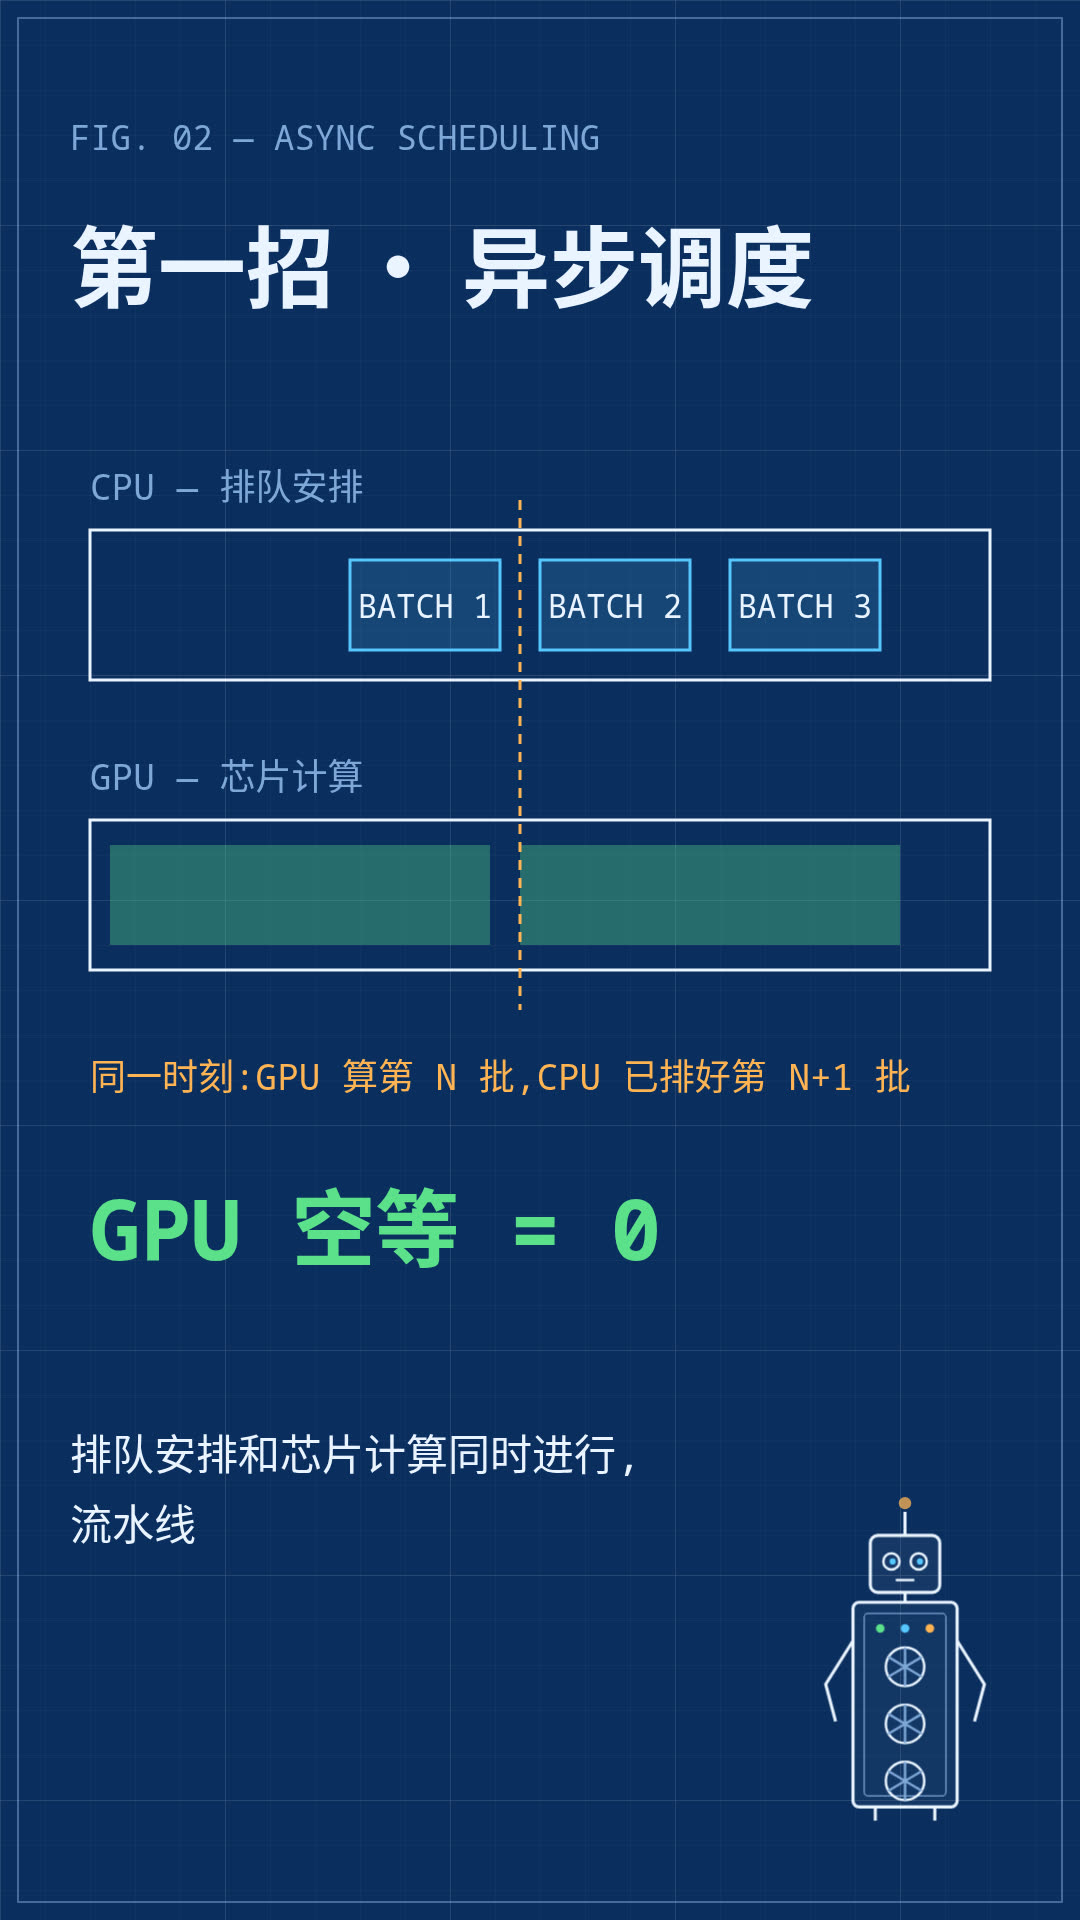
异步调度:排队安排和芯片计算同时进行,流水线永远满载。
小听: 第二招是那几百个专家?
沈知远: 对,MoE 混合专家。一个问题进来,路由器只唤醒最对口的几个专家,不用全员上场。难点是负载会歪:热门专家累死,冷门专家闲死。DeepInfer 用专家并行加 EPLB 负载均衡,把热门专家的副本分散到多张卡上,谁闲谁多干,没人摸鱼,也没人累死。
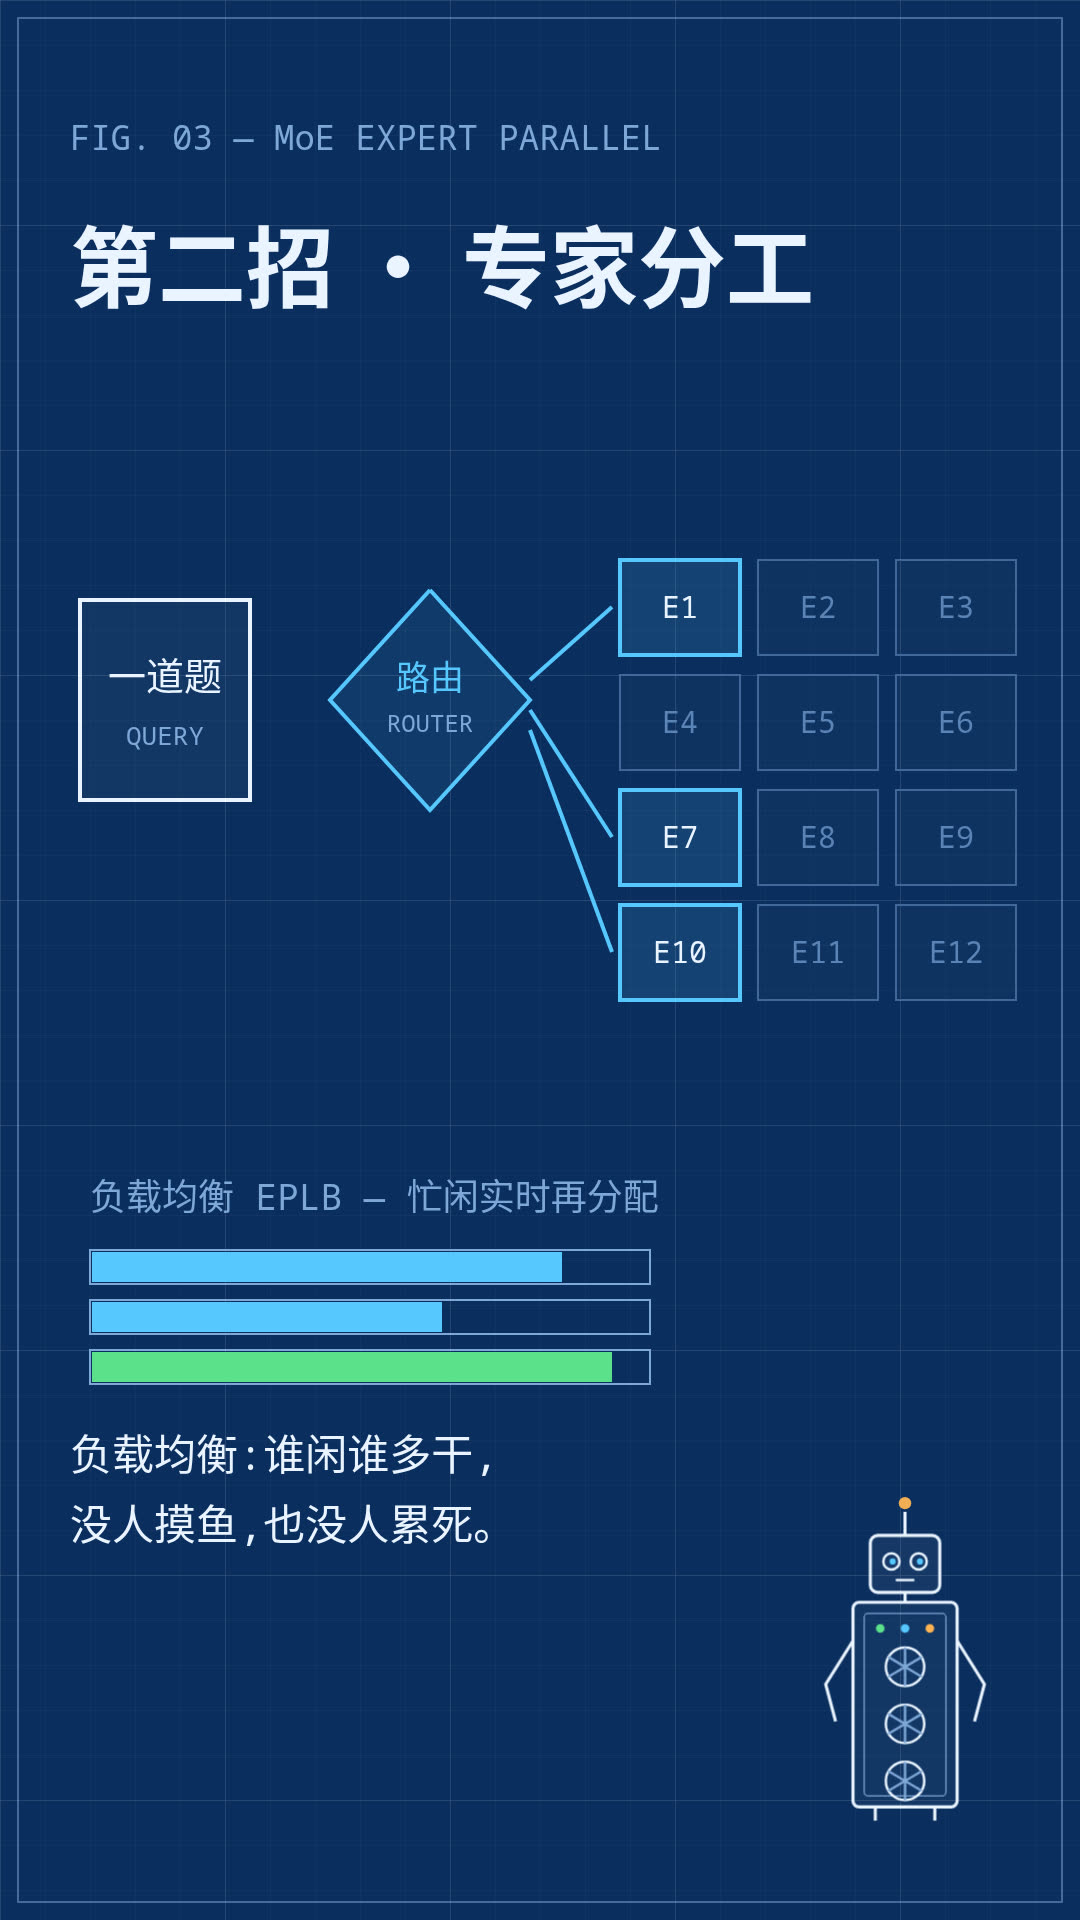
一道题只喊醒少数专家,其余的保持待机——省算力,也省电费。
小听: 第三招"草稿抢跑"听起来像作弊。
沈知远: 学名投机解码,DeepInfer 里叫 DSpark。先让小模型飞快猜出接下来最多 5 个词,大模型再一次性批量验算;猜对的直接交付,猜错也就浪费一次验算。它还按置信度调度验证顺序,把验算的算力花在刀刃上。
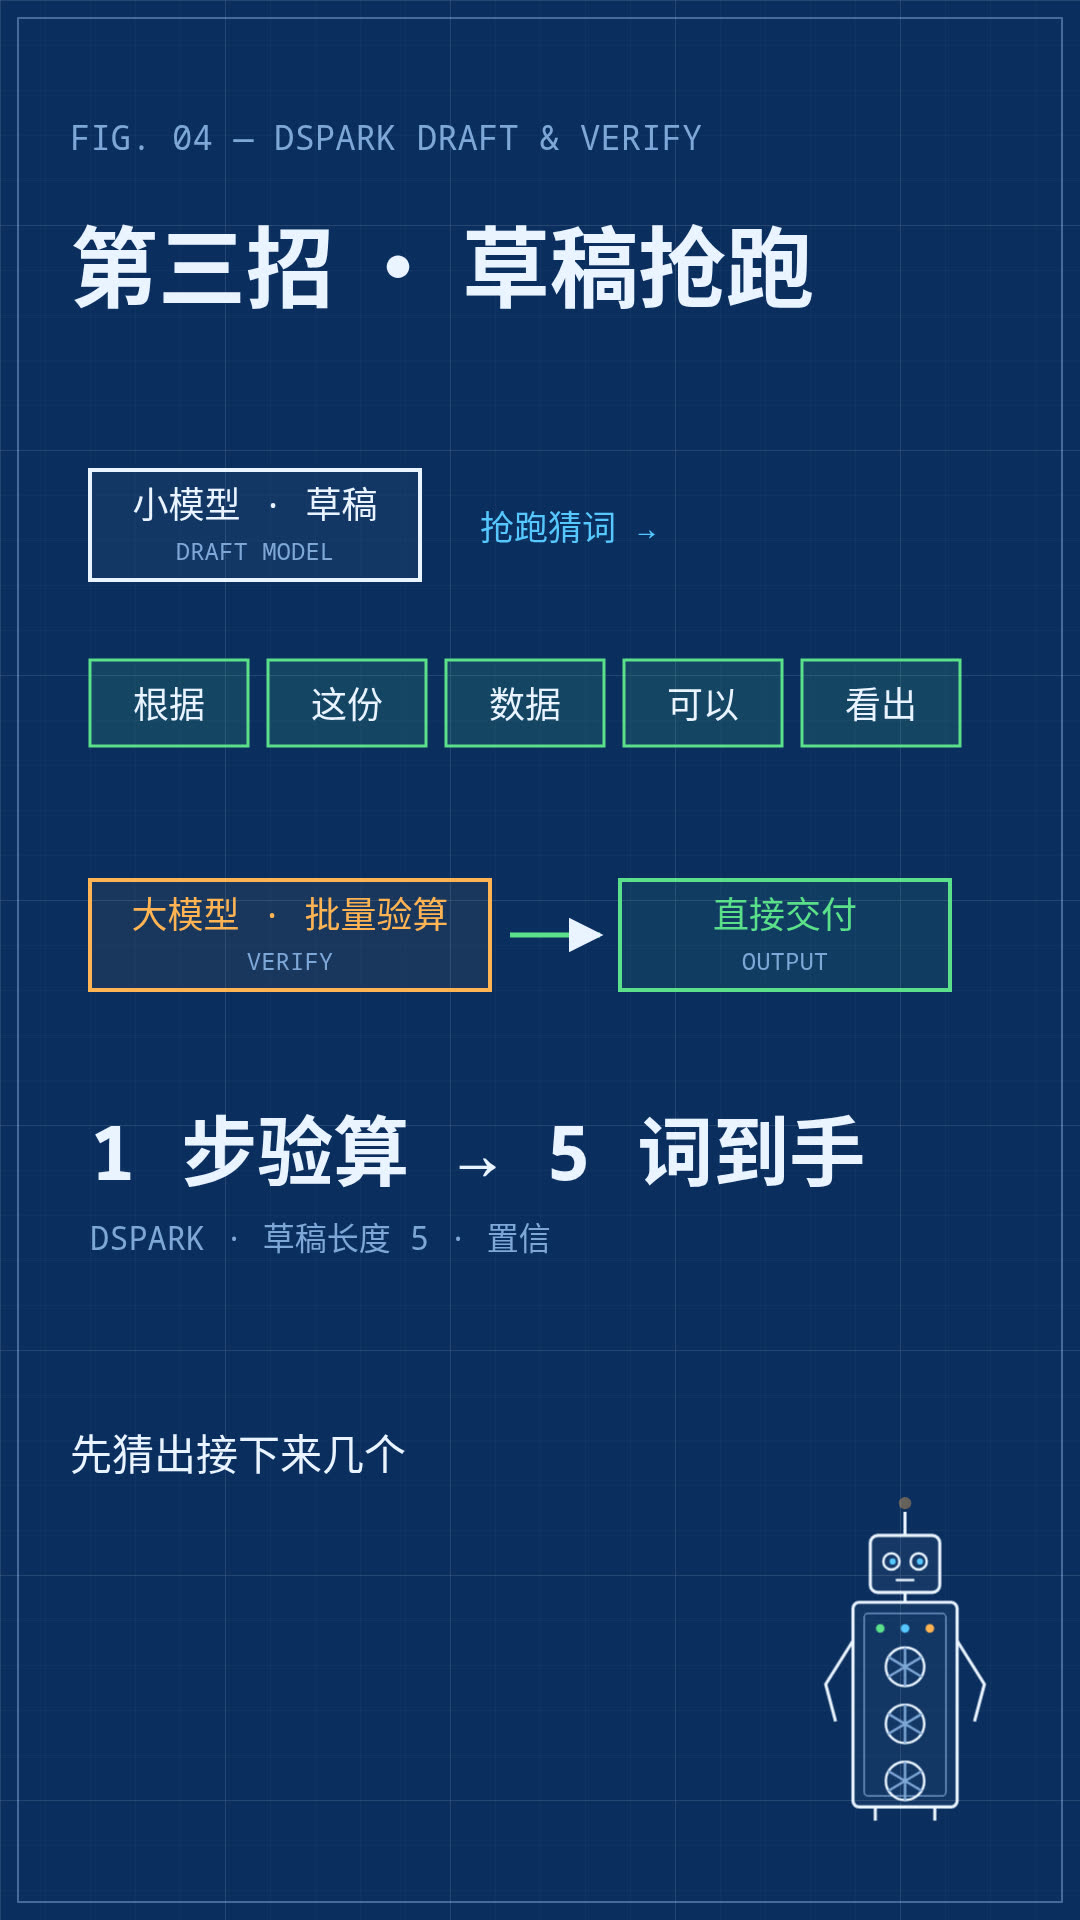
先猜后验:猜对一步顶好几步,这是推理加速这两年最热的一条路线。
小听: 还有个细节你说很硬核——"拼车不变"。
沈知远: 批量不变性。正常引擎里,你这句话跟谁拼在一批算,结果可能有微小差别,因为浮点运算顺序变了。DeepInfer 能让同一句话不管跟谁同批,输出分毫不差,再配上确定性采样:同样输入、同样参数,永远同样输出。做过线上服务的人都懂这有多难得——出了问题能复现,用户投诉能查账。
小听: 那它有没有留一手?
沈知远: 留了,而且明说。README 里列了"完整服务还需要、但这次没给"的三样:KV cache 系统、预填充/解码分离、跨副本负载均衡。给的是引擎本体和优化内核,线上调度看家的那套还在官方手里。硬件门槛也不低:英伟达要最新一代的 SM100,另一边支持华为昇腾 950。
小听: 最后一句总结?
沈知远: 它站在 vLLM 的肩膀上开源——README 里明说主要基于 vLLM 构建。这次,轮到全世界站在它的肩膀上了。