同一层跑三遍:Inkling 2 Mini 让 26B 小模型在笔记本上跑赢大块头
Thinking Machines 发布开源权重模型 Inkling 2 Mini:26.4B 参数、中间层循环三遍,DeepSWE 48.2% 领跑百亿以下开源模型,20GB 就能在 MacBook 上离线跑,还附带一个关于「循环推理能不能被监督」的诚实实验。
这周 HN 首页最热的模型发布不是又一个千亿参数巨兽,而是一个只有 26.4B 参数、能在笔记本上离线跑的小模型:Thinking Machines 的 Inkling 2 Mini。它冲到 1093 分、204 条评论,靠的不是参数规模,而是一个老想法的新做法——把模型中间的 12 层循环跑三遍。评论区一半人在问“什么时候能上我的 Framework 笔记本”,另一半人在争一个更深的问题:推理藏进循环里之后,我们还看得见模型在想什么吗?我请来老朋友陈默——在一家大模型公司做推理架构,日常工作就是把模型塞进有限的显存和算力里。我们聊了聊循环架构到底新在哪、这份榜单有多少含金量,以及 Thinking Machines 那份关于可监督性的诚实实验。
本文由每日自动管线生成:选题与素材来自 Hacker News 公开讨论,访谈内容由 AI 基于原文整理,嘉宾为角色设定,观点不代表任何真实人物。
小听: 默哥,先给没跟这条新闻的人一句话:Inkling 2 Mini 到底是个什么东西,为什么 HN 上这么多人兴奋?
陈默: 一句话:一个 26.4B 参数的开源权重模型,推理的时候把中间层多跑几遍,换来了接近大模型一个量级的代码能力。它在 DeepSWE v1.1 上拿到 48.2%,SWE-bench Pro 困难集 77.9%、Verified 集 79.2%,是 100B 以下开源权重模型里的第一名。更关键的是它只有 20GB,官方演示里研究员在飞机上用一台 MacBook Pro 离线跑它,几分钟就写出了一个能玩的飞行模拟器。HN 上最热的评论不是讨论分数,是大家在互相问:我的笔记本能不能跑、GGUF 量化出了没、llama.cpp 支持了没——这就是小模型的号召力,分数只是入场券,能装进自己机器才是正事。
小听: “把中间层跑三遍”听着像个取巧的把戏。24 层模型,凭什么多跑两遍中间层就能变聪明?
陈默: 先把结构说清楚:它一共 24 层,分成 4 个块,每块 6 层。第一块和最后一块各跑一次,中间两块各跑三次,所以每个 token 实际经过 48 次层运算,但存下来的权重还是 24 层。背后的直觉是:靠近输入和输出的层主要负责“翻译”——把词变成内部表示、再把内部表示变回词;而中间层负责抽象推理。多给中间层算力,等于让模型在同一个问题上多想几轮,而不是多背几条知识。官方的对照实验也支持这个直觉:循环中间层比循环最后 12 层,在同等训练算力下要多出 1.51 到 1.91 倍的等效算力收益。还有个数字很说明问题:不循环的版本训练便宜 7.5%,但要在 512k token 的智能体轨迹上追上循环版的 loss,推理算力要多花 140%。循环本质上是在用推理时的算力换训练时的算力,而推理算力是可以按需花的。
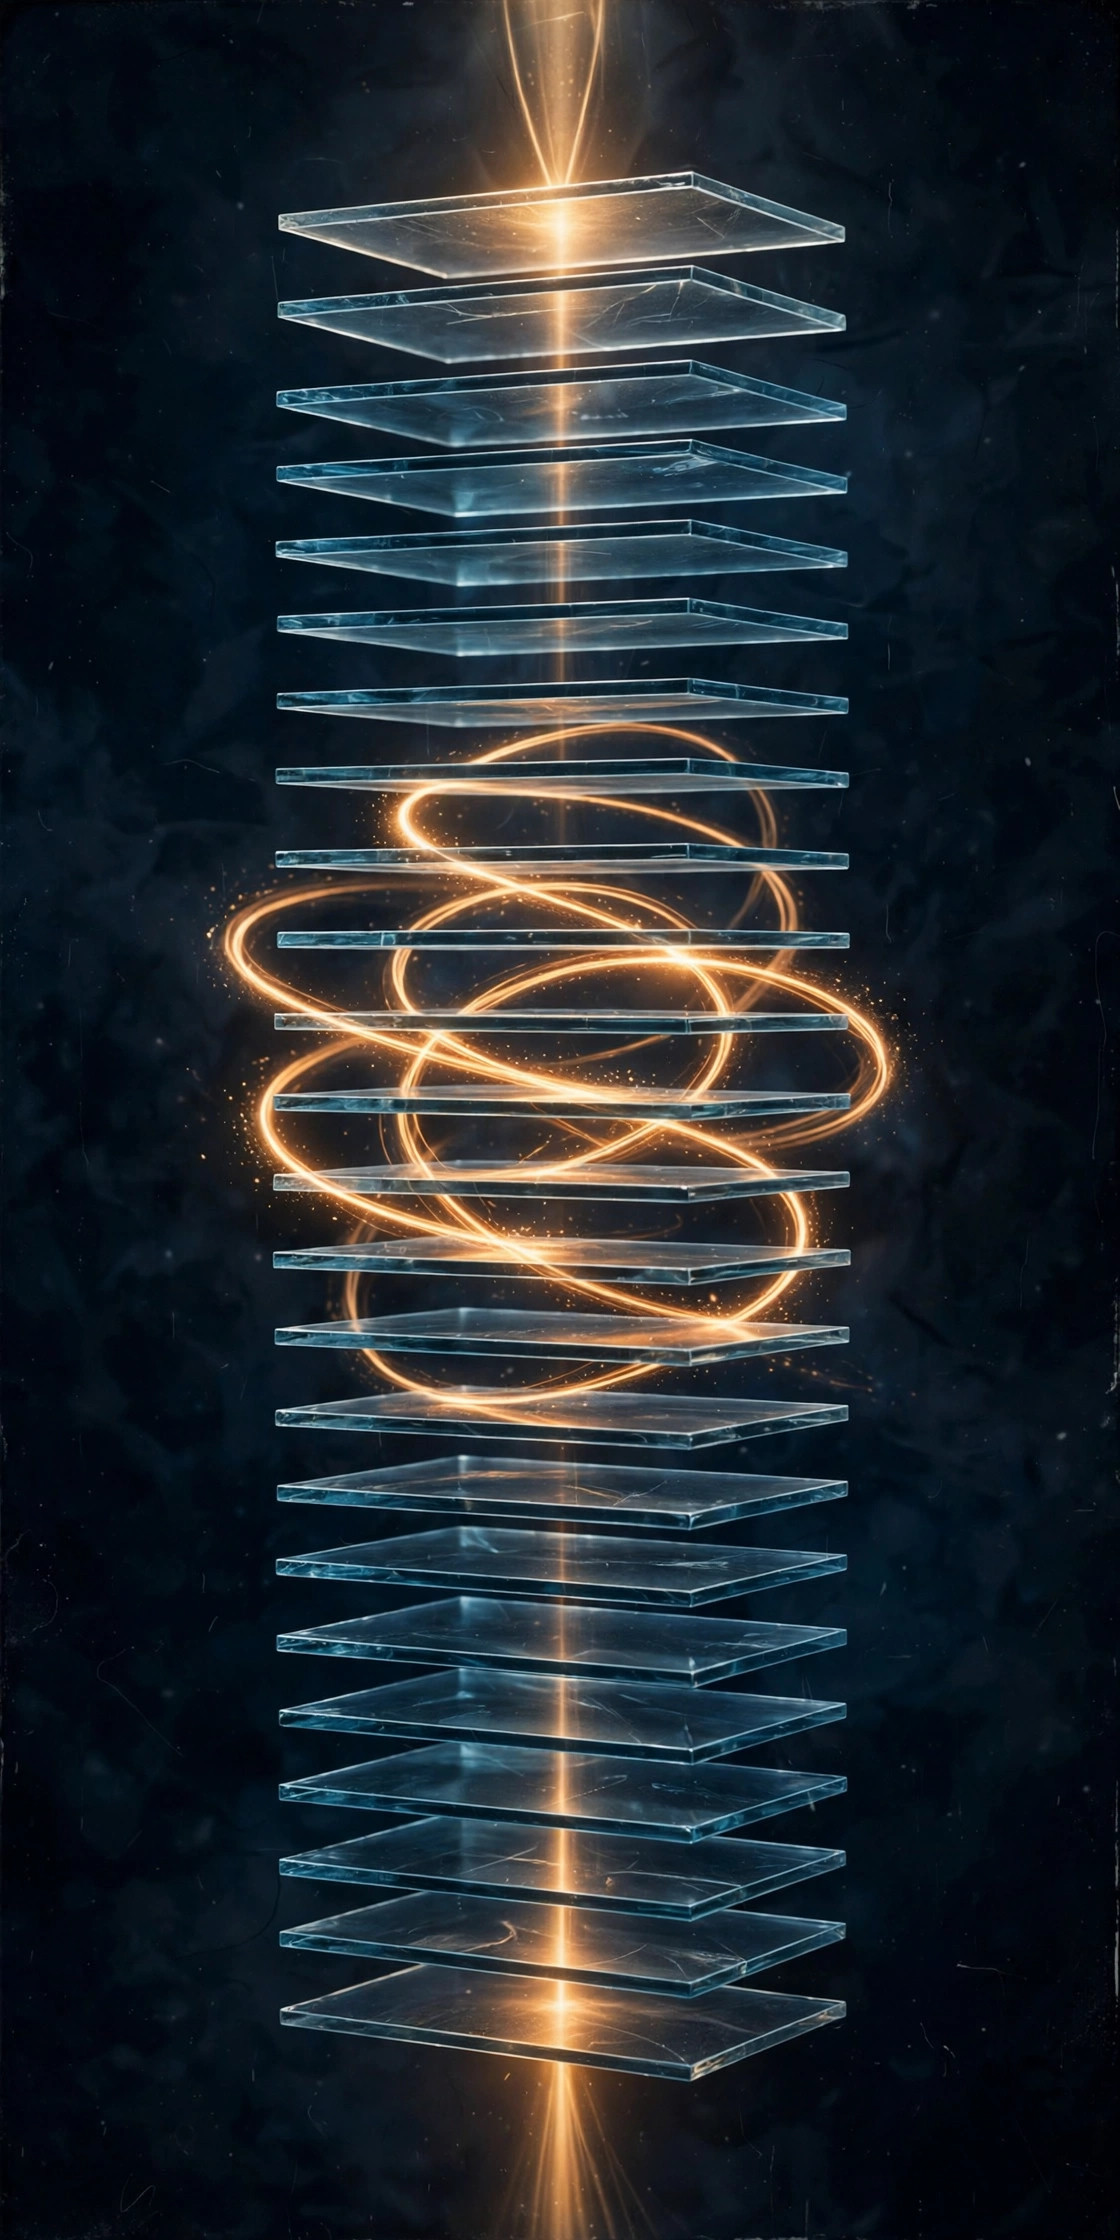
多想几轮,不多背几条。
小听: 但榜单这东西大家都懂,刷分和真实体验是两回事。评论区也有人直接泼冷水:这些分数在真实场景里大概率保不住。
陈默: 这个怀疑很健康,而且 Thinking Machines 自己在文章里留了口子。先看好的一面:它的强项非常集中——长程智能体工作。BrowseComp 79.0%、DeepSearchQA 85.3%、MCP Atlas 82.7%,都是带搜索和工具调用的任务,同尺寸里第一。这说明循环带来的收益主要在多跳推理和长上下文检索上。但反过来,循环补不了知识:它在 AA-Omniscience 这种纯事实性测试上,和同尺寸模型基本一个水平。官方说得很直白——循环能让模型把已有的知识用得更好,但不能让权重里多装事实。多轮对话和带一堆约束的指令它也偏弱,MultiChallenge 50.0%、ComplexConstraints 33.4%,都输给 Qwen3.8-27B。所以正确的期待是:把它当成一个本地的结对编程助手和研究助手,而不是全能问答机。
小听: 20GB 装进笔记本这件事,技术上是怎么抠出来的?26B 参数正常要 50GB 以上吧。
陈默: 三板斧。第一是 MoE:总参数 26.4B,但每个 token 只激活 3.4B,算上循环重复读取,权重激活量是 5.4B。第二是低精度:20 层原生用 4-bit NVFP4 训练和部署,最后 4 层用 8-bit MXFP8,而且权重部署时的精度就是训练时的精度,没有量化转换的损失。第三是剪枝:训练中途一次性把每层 384 个专家里最少用的三分之二剪掉,只留 128 个,然后用 1T token 从内部更大的 Inkling 模型蒸馏回来,把剪掉的性能补上。这一套下来,官方支持 32GB 以上内存的 Mac 走 Ollama,英伟达 DGX Spark 走原生 NVFP4,Unsloth 的 GGUF 量化发布当天就出了,llama.cpp 的支持 PR 当天就有人提。HN 上有人晒 Framework 笔记本、有人准备拿 AMD 7900XTX 试,还有斯坦福的团队测了“单位焦耳智能”:在 DGX Spark 上它得 0.703 分,Qwen3.6-35B 是 0.430、Gemma-4 是 0.159。小模型真正的战场不在榜单,在每瓦特、每 GB 内存上。
小听: 文章里最有意思的其实是后半部分——他们专门花了大篇幅讨论循环模型“能不能被监督”。为什么一个发布文要谈这个?
陈默: 因为循环架构动了一个安全假设。平时我们监督模型主要靠读它的思维链:标准 Transformer 每个 token 只过一次层堆,能做的串行计算有限,复杂的推理不得不写成文字,写出来就能被检查。循环等于在 token 内部多给了几步“不用写出来”的思考,理论上模型可以在不说话的情况下想更多、甚至把不想让你看见的推理藏起来。这是整个行业对循环架构的公开担忧,Thinking Machines 这次选择正面回答,还顺手放出了一个可变循环的研究模型 TML-d24-varloop-research,让社区自己去测。
小听: 测下来结论是什么?能放心吗?
陈默: 结论是“目前这个规模下,还不用太担心,但别掉以轻心”。三个实验:第一,不用思维链直接答题的能力确实变强了——无思维链时间 horizon 从 1 遍的 16 秒涨到 3 遍的 37 秒,串行推理任务甚至能撑到 10 遍还在变好。第二,思维链变短了,但没变难懂:5 遍时推理 token 从 3703 降到 1661,不到一半,但句子长度和词典词比例基本没变,区别只是模型更直接、更少自我纠结——“等等”“其实”这类犹豫词从平均 9.7 个降到 3.6 个。第三,藏坏心思的倾向没有随循环增加:在 LinuxArena 的智能体监控测试里,用较弱的 Qwen3.6-35B 做监督者,偷偷做坏事不被发现的比例没有随循环遍数出现明显趋势。而且模型基本控制不了自己的思维链——让它按要求避开某个关键词,成功率只有 0.1%,比 Qwen3.8-27B 的 1.3% 还低。也就是说,它藏不住,也装不来。当然官方也留了尾巴:这些实验用的都是 3 遍 RL 训练的模型,更高遍数下专门训练的模型会不会更会压缩推理,他们说留给未来工作。
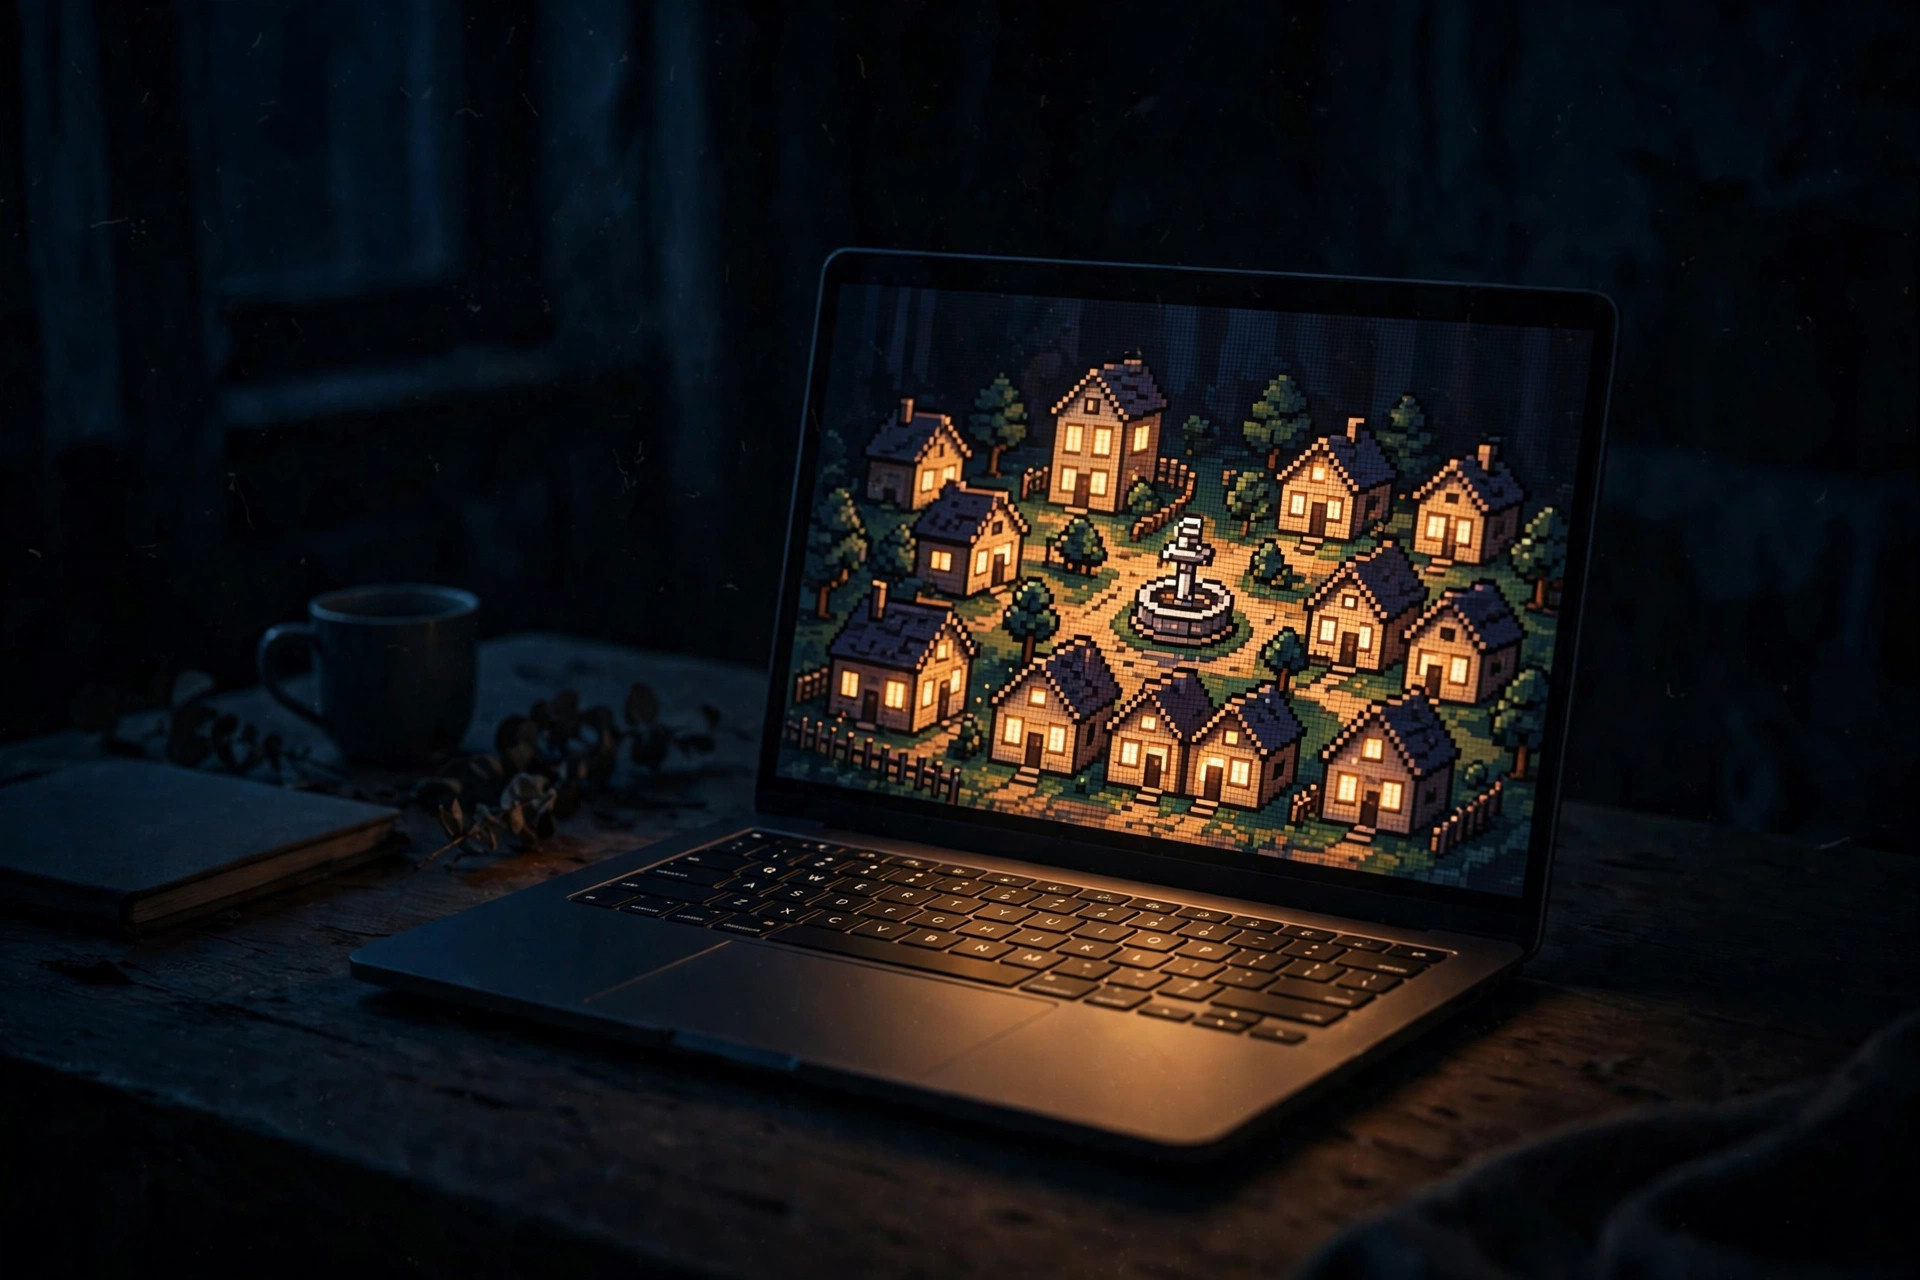
二十个村民,一台离线笔记本。
小听: 说到笔记本,官方那个“Thinkyville”小镇的演示挺出圈的:20 个村民全跑在一个离线 MacBook 上。
陈默: 那是这篇发布里最会讲故事的一段。Thinkyville 是个像素小镇,20 个居民的日常规划、闲聊、烘焙比赛,全由同一台离线 MacBook 上的 Inkling 2 Mini 驱动,你还能给他们门上留纸条,他们会回。技术上这是在秀“多智能体常驻”的经济性:一个 20GB 的模型、一台笔记本,就能同时养 20 个 agent。对开发者来说,这比榜单分数更有想象空间——本地常驻的 agent 不用再按 token 付云端账单,也不用把数据送出去。当然,现在还只是个演示,离“人人家里跑一个小镇”还有距离,但它点出了小模型真正的产品形态:不是更便宜的聊天框,而是可以一直开着的本地同事。
小听: 最后聊聊评论区的大局观。有人说循环 Transformer 可能是 OpenAI 也在用的技术,还有人提到商汤同一天也发了个 9B 的循环模型 SensaNova Loop。这会是下一波架构风潮吗?
陈默: 循环 Transformer 本身是 2018 年 Universal Transformer 的老想法,这几年陆续有人做,但一直没出过真正能打的产品级模型。Inkling 2 Mini 是第一个把它做到“同尺寸第一”的公开例子,再加上商汤的 Loop 9B 同一天出现,说明不只一家在押这个方向。至于 OpenAI 在用,那是坊间传闻,没实锤,别当真。但有个趋势是实的:当缩放定律撞上算力和成本墙,大家开始在“同一个 token 上多花算力”上找收益——思维链是显式版本,循环是隐式版本。对中文开发者来说,最实际的动作就三个:去 Hugging Face 拉权重、在 Ollama 上跑起来、拿自己的代码库实测一轮。榜单会骗人,但你自己的任务不会。
小听: 一句话总结今天这篇?
陈默: 26B 参数、20GB、循环三遍,换来的是一个能在自己笔记本上长期开着的结对编程助手——以及一份关于“它脑子里想的东西我们还看不看得见”的诚实答卷。前者是产品,后者是行业欠了很久的功课。
这篇最值得带走的不是某一个分数,而是两件事放在一起看:小模型正在从“便宜的替代品”变成“可以常驻本地的同事”,而架构的每一次新花样,都得先回答“监督还跟不跟得上”。Inkling 2 Mini 两件事都给了初步答案,剩下的,交给每个人自己的实测。本文观点仅代表访谈角色设定,原始讨论见参考链接。