小模型住进笔记本,中间层跑三遍|听懂AI #102
思考机器实验室的因克林迷你只有 264 亿参数,20 吉内存就能在笔记本上离线跑。秘诀是循环架构:中间十二层每个字跑三遍,写代码深度榜 48.2% 拿下百亿以下开源第一。
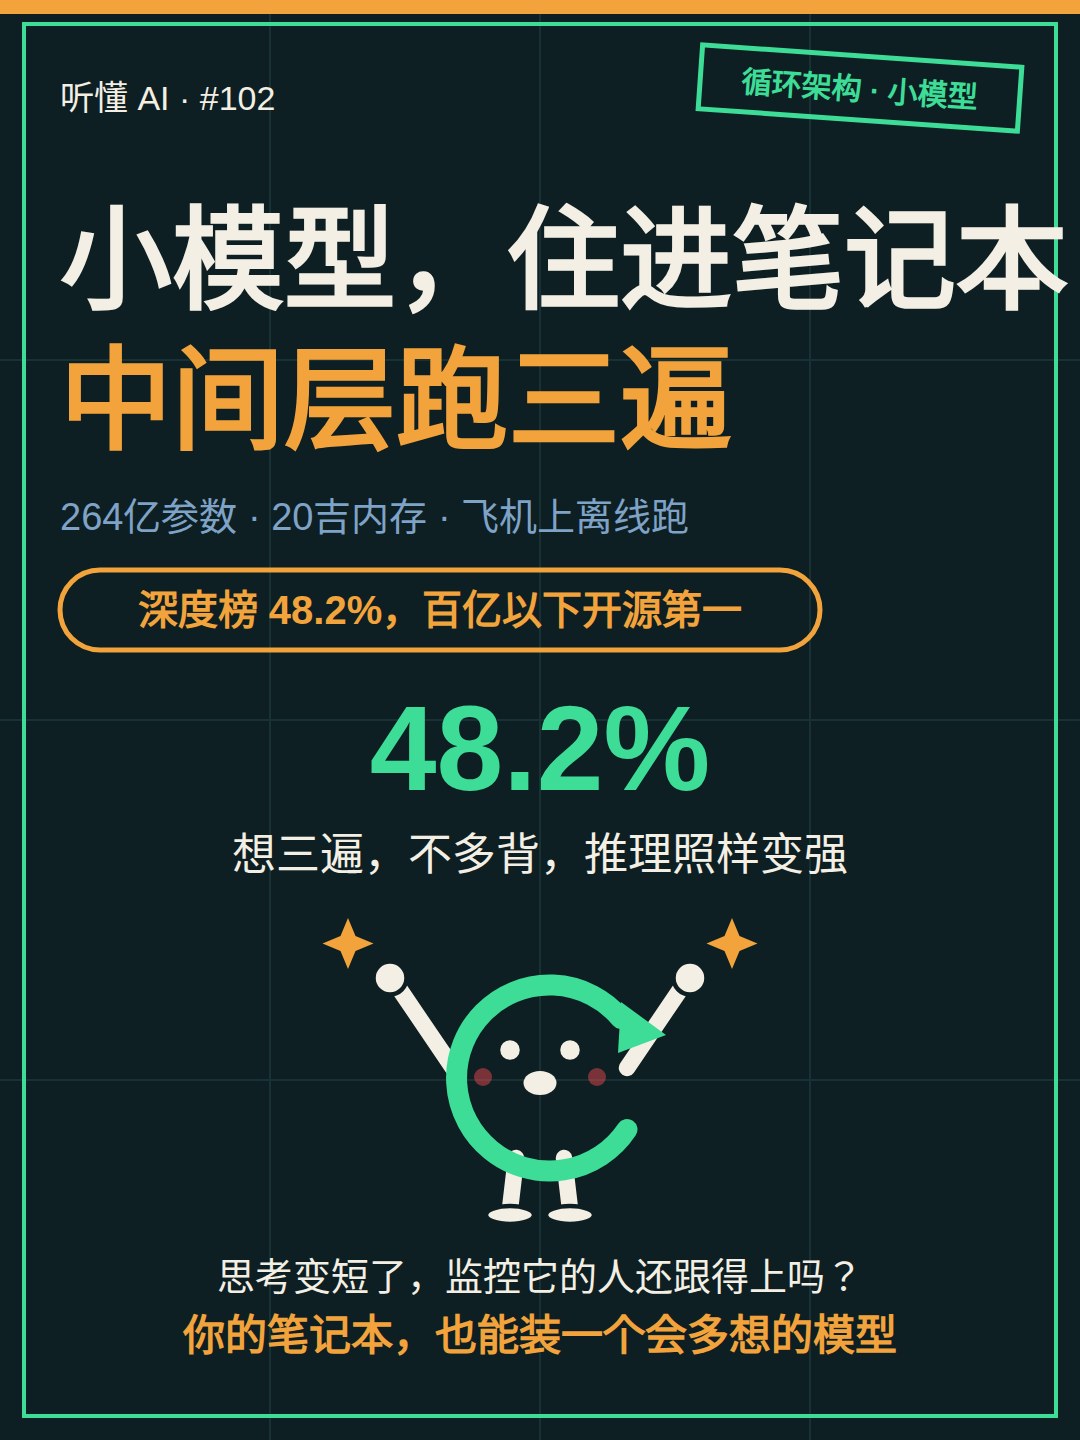
十一月二十号,思考机器实验室发布了因克林迷你,一个只有两百六十四亿参数的小模型。参数总量 26.4B,激活的只有 3.4B,整个模型二十吉字节,苹果本三十二吉内存就能跑。HN 讨论 1335 分、273 条评论,当天热度前列。
它最出圈的演示是在飞机上:研究员打开笔记本,飞行模式,离线跑着它,几分钟就写出一个能玩的飞行模拟器。
秘诀就一个字:绕
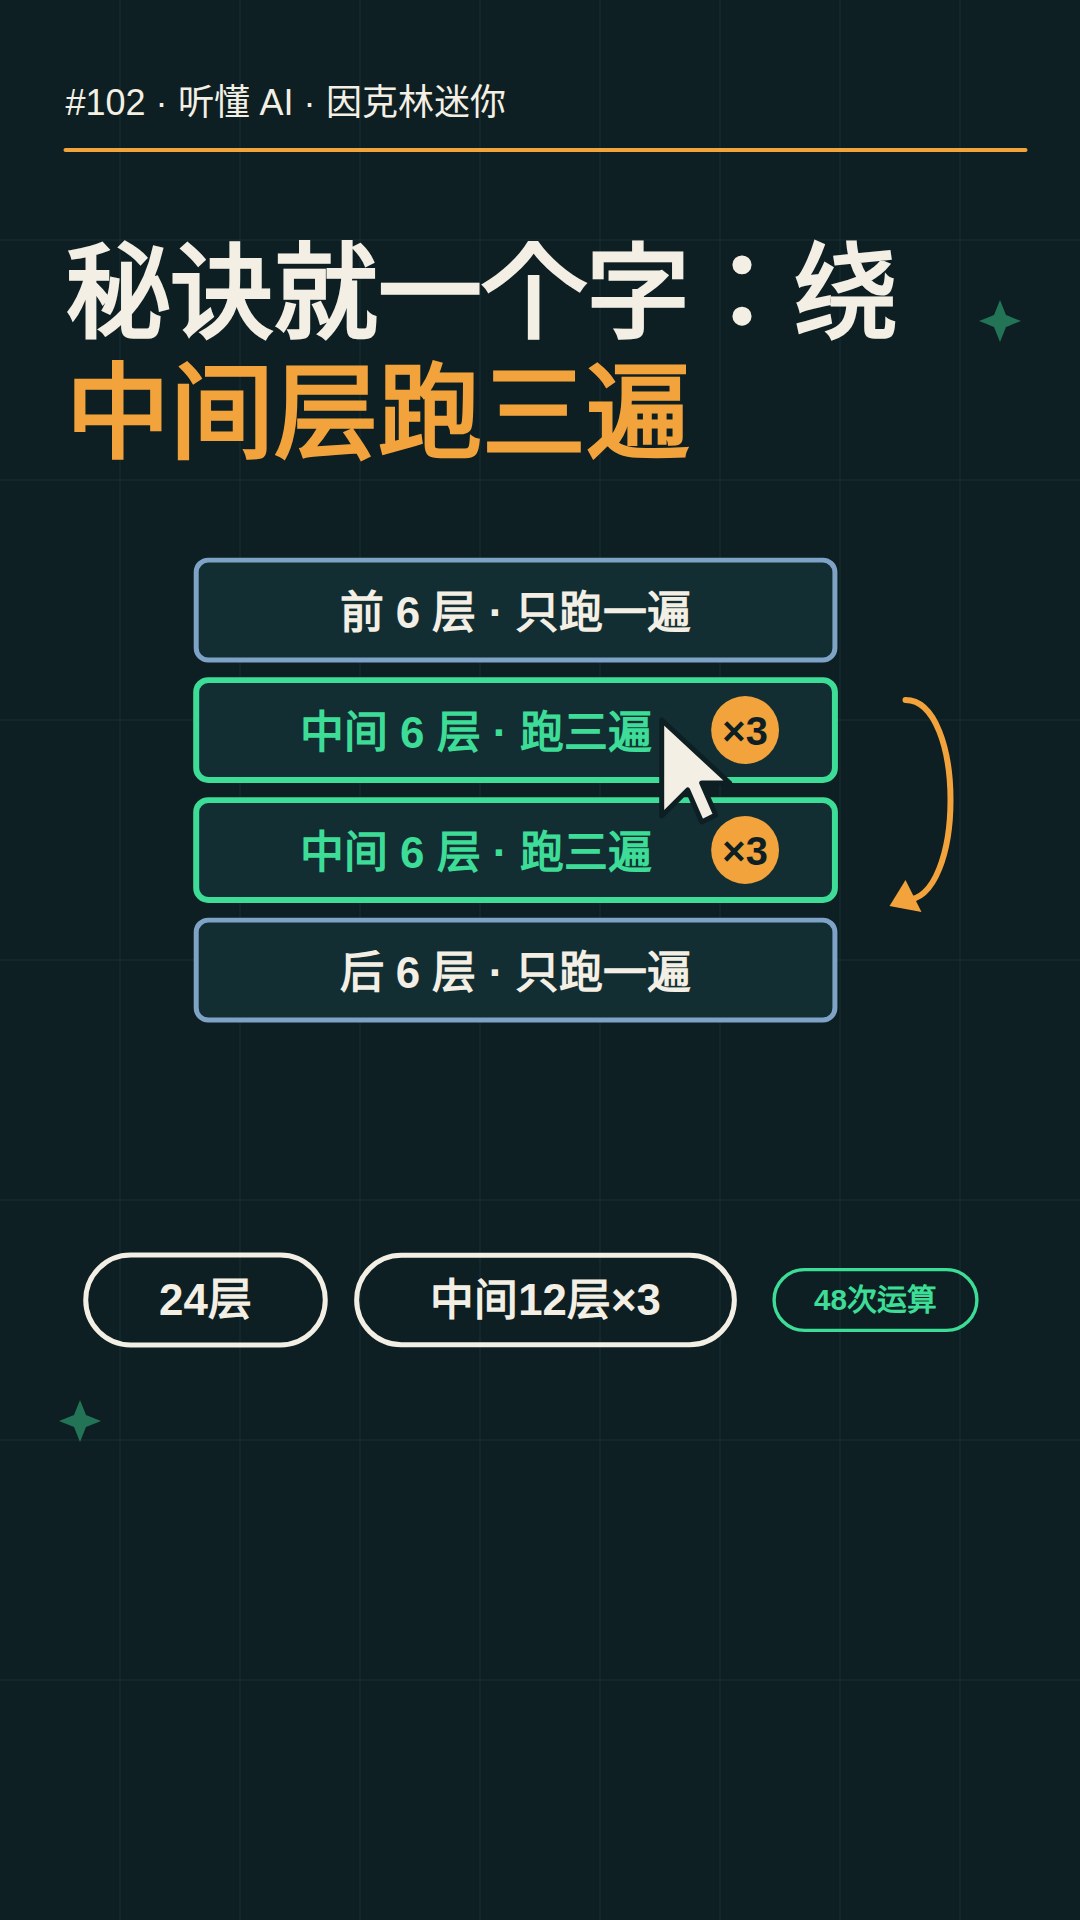
因克林迷你是个循环架构模型,一共二十四层,分成四块,每块六层。第一块和最后一块,每个字只跑一遍;中间两块,中间十二层,每个字跑三遍。
二十四层存着,四十八次运算。参数没变多,算的次数变多了。实验室的说法是:中间层负责更抽象的推理,多跑几遍,等于把脑子多转两圈再往下走。
为了让循环稳定,他们还加了一个门控:每一遍开始,都从第一块的输出出发,第二遍、第三遍再额外读上一遍留下的信息。门控一开始几乎关死,循环和不循环没区别,训练中再慢慢打开。
多想,不多背
多转两圈换来的是多想,不是多背。知识主要看参数总量,参数没涨,知识就不涨;但推理变强了。
实验室用了一个不写思考过程的测试:不让模型写推理步骤,直接答题,能答的题难度按人类完成时间算,从十六秒涨到三十七秒。串联推理的测试里,循环次数加到十遍,成绩还在涨——哪怕它训练时最多只见过五遍。
写代码的成绩单很能打:深度软件工程榜上,它拿了百分之四十八点二;综合榜百分之四十六点五。一百亿参数以下的开源模型里,它是第一。长上下文的检索测试也跟着涨,唯独纯靠背知识的问答,循环帮不上忙。
飞机上写了个游戏
最有说服力的不是榜单,是那次飞行演示。模型原生就是四比特精度训练、部署的,二十吉字节塞进笔记本,离线也能跑。研究员在飞机上打开苹果本,飞行模式,几分钟写出一个能玩的飞行模拟器。
实验室还提了一个有意思的用法:二十个小人住在一个像素小镇里,全镇的日程、闲聊、烘焙比赛,都由同一台离线笔记本上的因克林迷你管着。
想得越多,写得越少
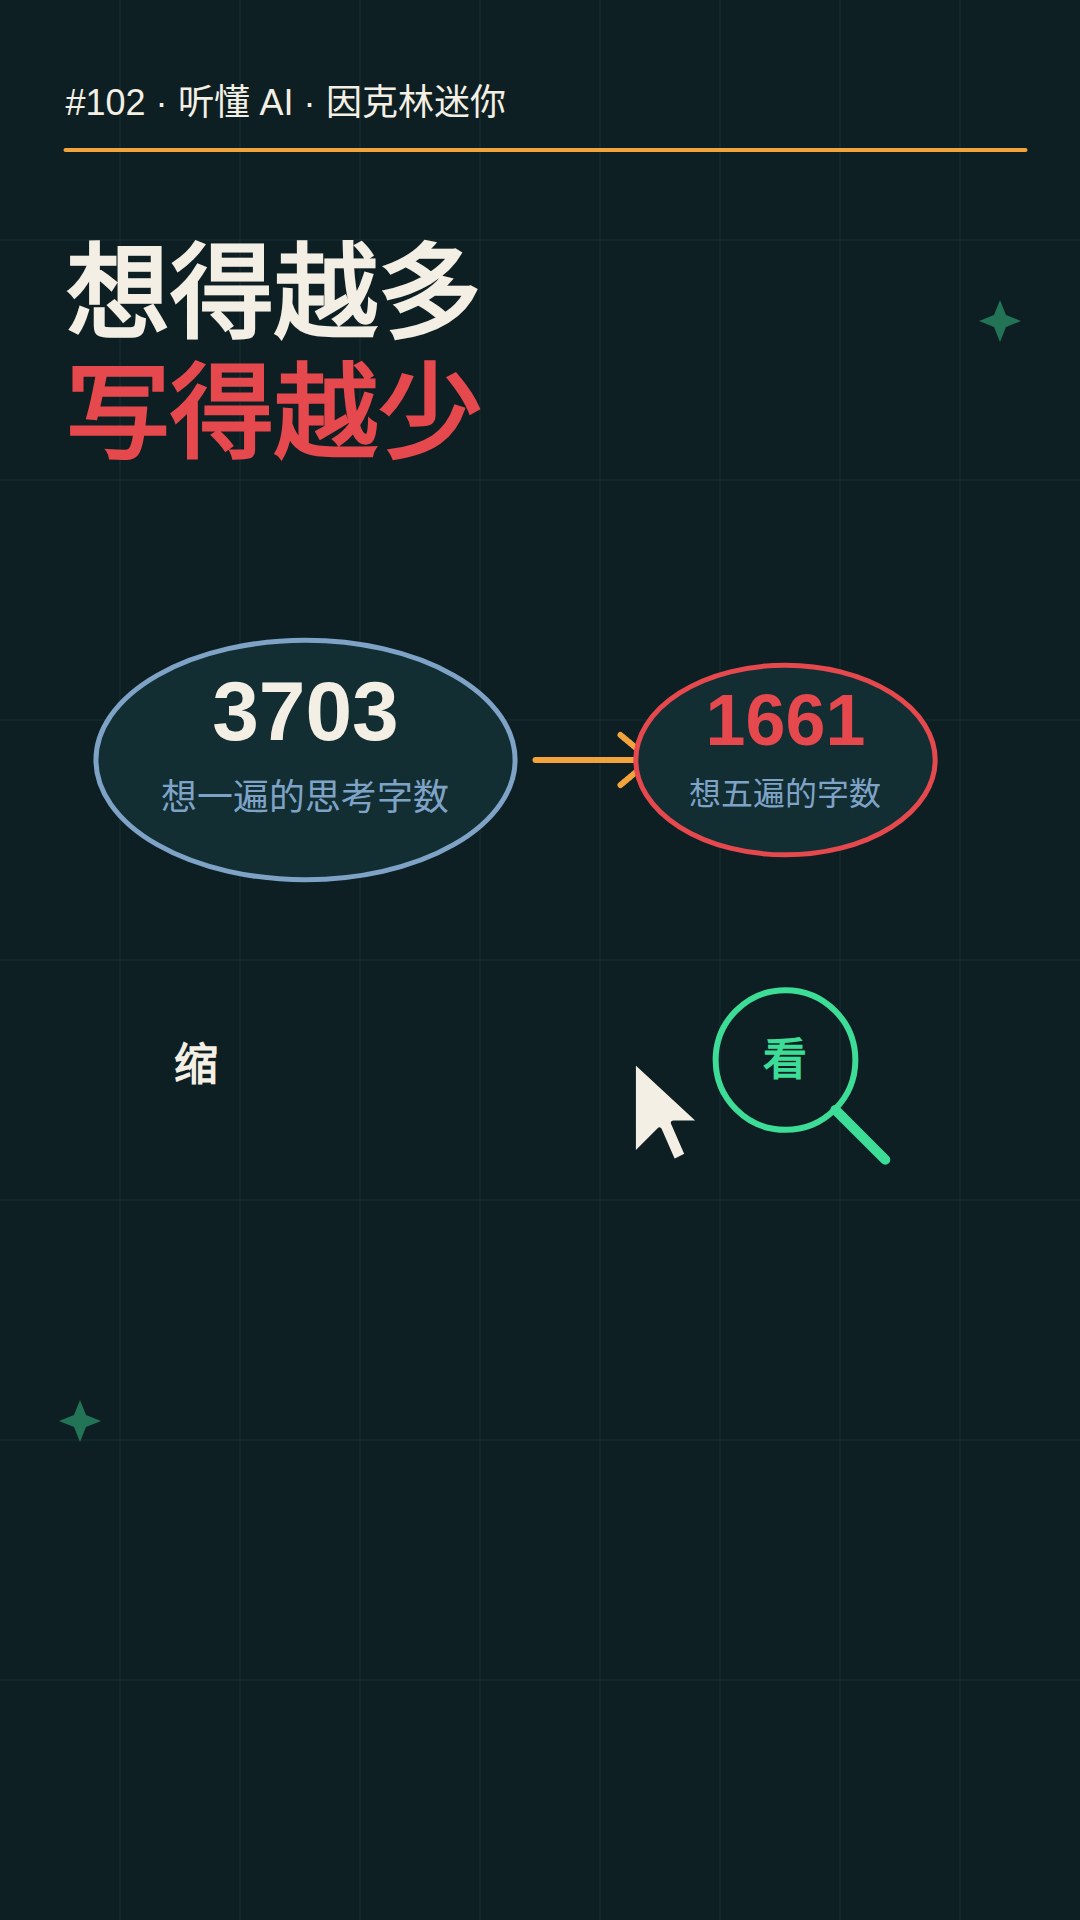
当然也有隐忧,而且是实验室自己先提出来了:循环让模型在心里想得更多,写出来的思考就变短了。
同一道题,想一遍要写三千七百个字,想五遍只要一千六百个字,缩短了一半还多。字数少了,但意思没丢:句子长度、常用词比例都没变,只是少绕弯路、少自我纠正。
问题是,思考过程都藏进循环里了,监控它的人,还跟得上吗?
目前的实验说跟得上:在模拟攻击的测试里,模型偷偷干坏事,基本都会被监控模型发现,循环次数多少没有明显影响。而且他们特意放出了一个可变循环的研究版,循环次数一到五遍都能调,就是请全世界一起来研究:循环模型到底该怎么监督。
你的笔记本,也能装一个
开源权重已经放出,支持苹果本、英伟达桌面 AI 电脑和各种本地推理框架。你的笔记本,也能装一个会多想几轮的小模型。
本期视频《听懂 AI》#102:小模型住进笔记本,中间层跑三遍。嘉宾:沈知远 · AI 系统研究员。信源:Thinking Machines Lab《Introducing Inkling 2 Mini》(2026-11-20);Hacker News 讨论 HN 50581260。配乐:Kevin MacLeod《Easy Lemon》(CC BY 4.0)。