十年老模型,赢了大模型:皮肤癌诊断 62% 对 42%|听懂AI #073
出题的是一位皮肤科医生。他从公开数据集里随机抽了 200 个病变,全部经过活检确诊:一半是必须留下来治的,包括 30 个黑色素瘤;一半是可以放心出院的良性病变。然后让三方在六种诊断里选一个,规则完全相同。 最能说明问题的是耳朵上一个不到 0.8 毫米厚的侵袭性黑色素瘤。
一个十年前的老模型,刚刚打败了今天最强的大模型。比的,是皮肤癌诊断。
出题的是一位皮肤科医生。他从公开数据集里随机抽了 200 个病变,全部经过活检确诊:一半是必须留下来治的,包括 30 个黑色素瘤;一半是可以放心出院的良性病变。然后让三方在六种诊断里选一个,规则完全相同。
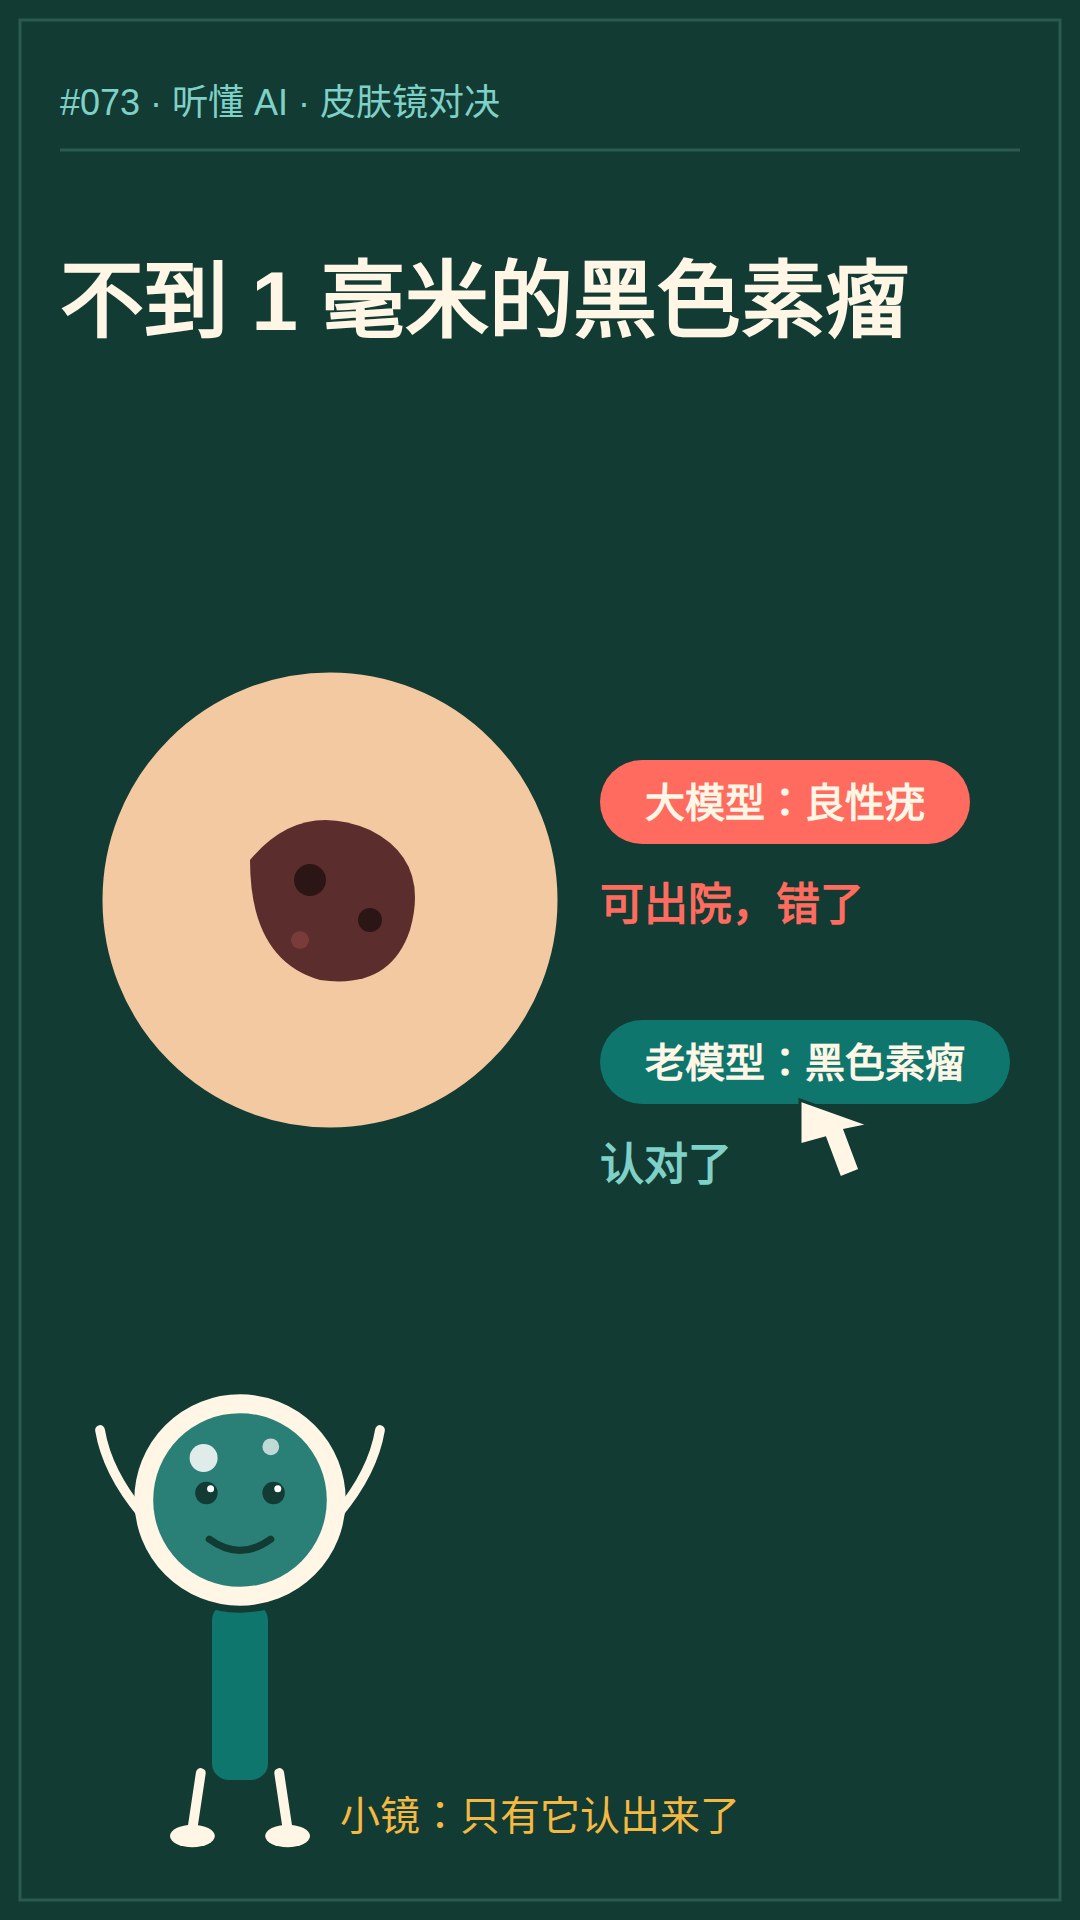
最能说明问题的是耳朵上一个不到 0.8 毫米厚的侵袭性黑色素瘤。两个大模型都说是良性的脂溢性角化病,可以出院;只有老模型根据皮肤镜图像认出了黑色素瘤。还有一例色素很少的黑色素瘤,大模型以 95% 的自信喊成了基底细胞癌,老模型答对了。
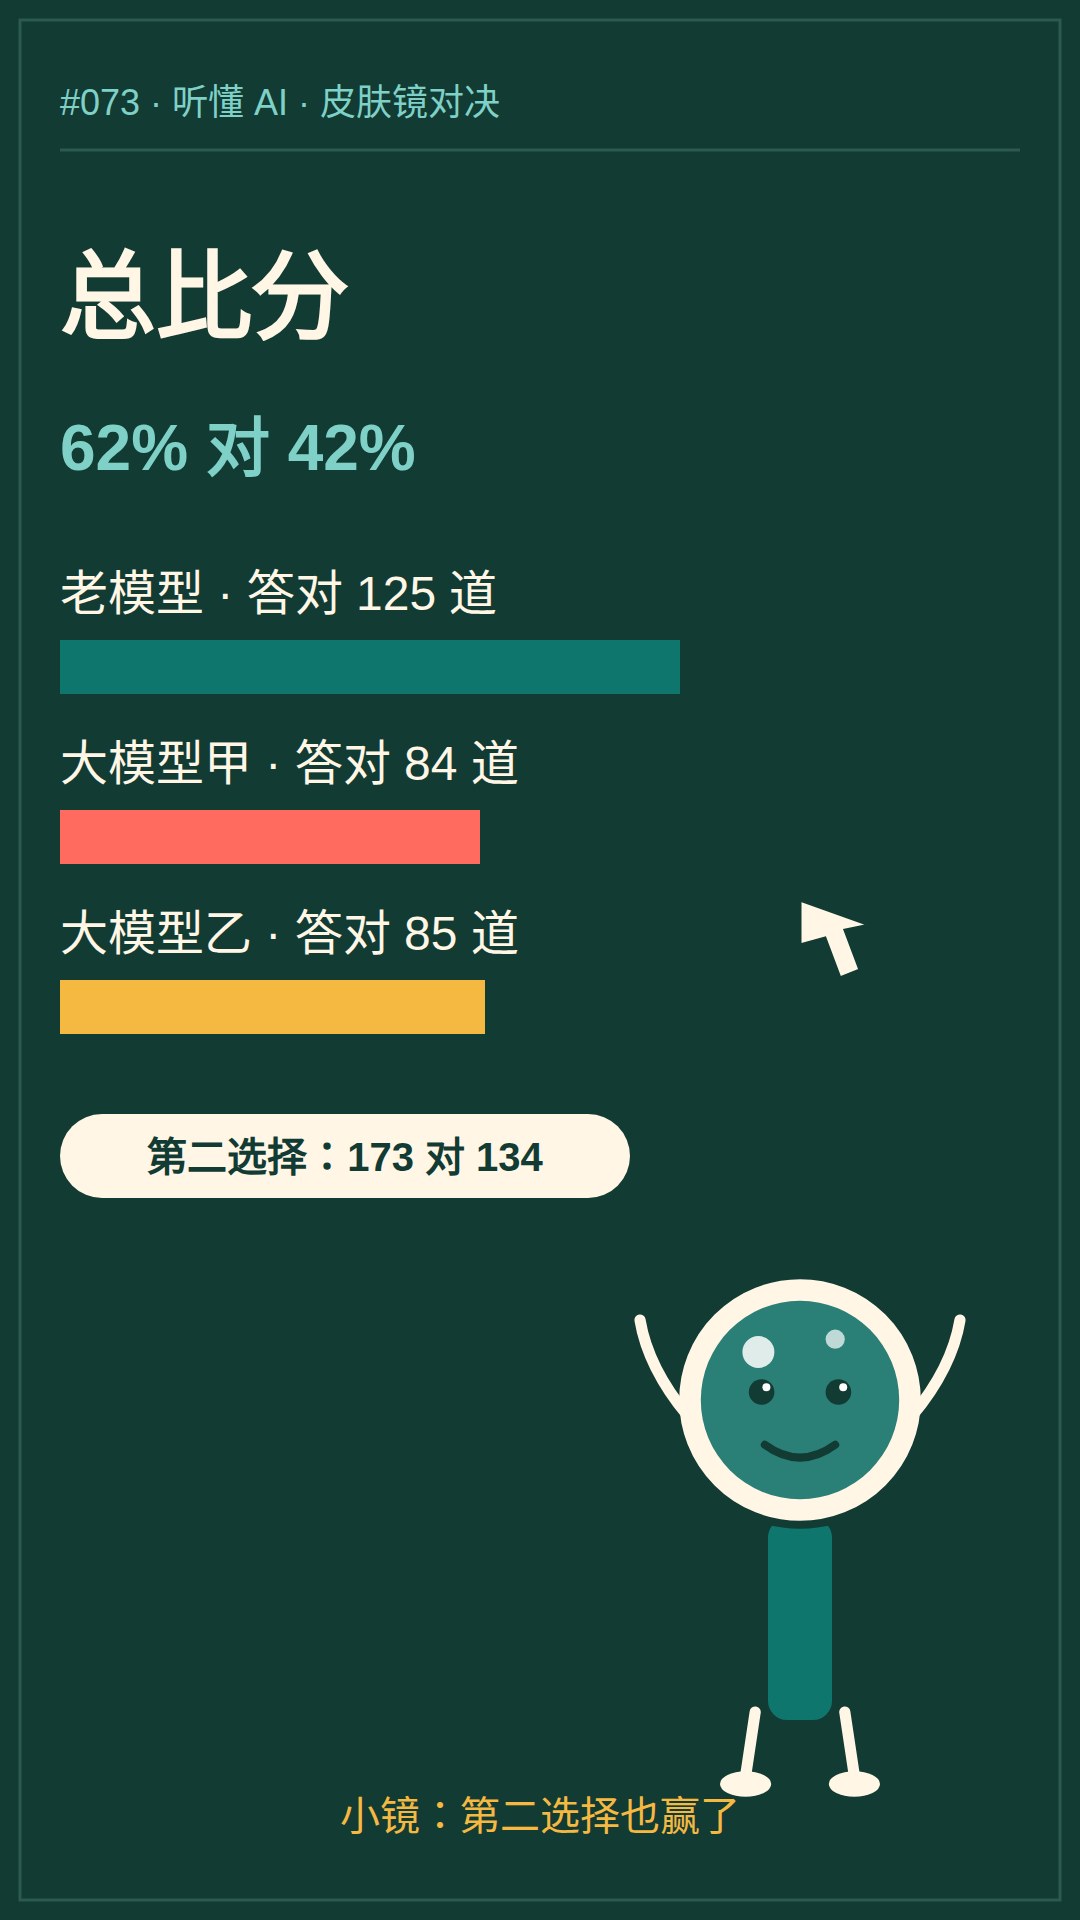
总分:老模型答对 125 道,62%;两款大模型分别是 84 道和 85 道,都是 42%。算上第二选择,老模型 173 道,对 134 和 138 道。黑色素瘤 30 道里,老模型首选答对 13 道,大模型是 8 道和 11 道。
而且大模型错得很有规律。每个大模型都有自己的“口头禅答案”:一个把 75 个病变喊成基底细胞癌,实际只有 25 个;另一个把 53 个喊成光化性角化病,实际只有 20 个。老模型的黑色素瘤错题则偏向另一边,17 道错题里 8 道喊成了痣,6 道喊成了脂溢性角化病。
老模型为什么能赢?恰恰因为它专。它是 2015 年发表的卷积神经网络 Inception v3,先在日常照片上预训练,再用 68011 张皮肤图像微调,微调只用了大约二十分钟,而且 200 道考题事先全部从训练数据里剔除,它没见过这些题。更关键的是,它小到能整个装进手机浏览器里、用本地算力跑,不用上传任何照片。
但这个结论不能直接推广,作者自己也列了三点提醒:第一,样本只有 200 例,30 个黑色素瘤的误差范围很宽;第二,全部是活检过的难病例,日常图像上差距会不同;第三,数据集 2025 年就公开了,大模型训练时可能见过——如果有,那还是帮了大模型。另外,这个老网络只是基线,不是皮肤癌诊断 AI 的最高水平,正规产品要好得多。
所以这期的结论是:专精的小模型,照样能赢通用大模型。但别把它读成“大模型不行”——读成“选对工具”才对:窄任务上,一个为任务而生的小模型,常常比什么都懂一点的大模型更可靠。
本文由每日自动管线生成:选题与素材来自 Hacker News 公开讨论(HN 50233779)与皮肤科医生 Magnus Lynch 的文章《A 10-year-old CNN outperforms frontier LLMs for skin cancer diagnosis》,访谈内容由 AI 基于公开资料整理,嘉宾为角色设定,观点不代表任何真实人物。
小听: 今天这期有个很反直觉的结论:一个十年前的老模型,在皮肤癌诊断上打败了今天最强的大模型。先说说,这场对决是怎么比的?
沈知远: 出题的是一位皮肤科医生。他从公开数据集里随机抽了 200 个病变,全部经过活检确诊——一半是必须留下来治的,包括 30 个黑色素瘤;一半是可以放心出院的良性病变。然后让三方在六种诊断里选一个,规则完全相同。
小听: 三方是哪三方?
沈知远: 两款 2026 年 10 月最前沿的大模型,和一个 2015 年发表的卷积神经网络 Inception v3。这个老网络先在日常照片上预训练,再用 68011 张皮肤图像微调,微调只用了大约二十分钟,而且 200 道考题事先全部从训练数据里剔除,它没见过这些题。
小听: 有没有哪道题特别能说明问题?
沈知远: 耳朵上一个不到 0.8 毫米厚的侵袭性黑色素瘤。两个大模型都说是良性的脂溢性角化病,可以出院;只有老模型根据皮肤镜图像认出了黑色素瘤。还有一例色素很少的黑色素瘤,大模型以 95% 的自信喊成了基底细胞癌,老模型和另一款大模型答对了。
小听: 总分呢?
沈知远: 老模型答对 125 道,62%;两款大模型分别是 84 道和 85 道,都是 42%。算上第二选择,老模型 173 道,对 134 和 138 道。黑色素瘤 30 道里,老模型首选答对 13 道,大模型是 8 道和 11 道。
小听: 大模型错得有规律吗?
沈知远: 很有规律。每个大模型都有自己的“口头禅答案”:一个把 75 个病变喊成基底细胞癌,实际只有 25 个;另一个把 53 个喊成光化性角化病,实际只有 20 个。老模型的黑色素瘤错题则偏向另一边,17 道错题里 8 道喊成了痣,6 道喊成了脂溢性角化病。
小听: 老模型为什么能赢?它不是更旧、更小吗?
沈知远: 恰恰因为它专。它只干一件事,而且干这件事的数据全是皮肤图像。更关键的是,它小到能整个装进手机浏览器里、用本地算力跑,不用上传任何照片。通用大模型见过全世界,但在这个窄任务上,专精打败了通用。
小听: 这个结论能直接推广吗?200 道题是不是少了点?
沈知远: 不能直接推广,作者自己也列了三点提醒:第一,样本只有 200 例,30 个黑色素瘤的误差范围很宽;第二,全部是活检过的难病例,日常图像上差距会不同;第三,数据集 2025 年就公开了,大模型训练时可能见过——如果有,那还是帮了大模型。另外,这个老网络只是基线,不是皮肤癌诊断 AI 的最高水平,正规产品要好得多。
小听: 所以这期的结论到底是什么?
沈知远: 一句话:专精的小模型,照样能赢通用大模型。但别把它读成“大模型不行”——读成“选对工具”才对:窄任务上,一个为任务而生的小模型,常常比什么都懂一点的大模型更可靠。
小听: 谢谢沈知远。完整测试数据、提示词和评分代码,作者都已公开;本期视频的选题来源是 Hacker News,原文作者为皮肤科医生 Magnus Lynch。
参考链接
- Lynch Lab:A 10-year-old CNN outperforms frontier LLMs for skin cancer diagnosis — https://lynchlab.net/llm-skin-cancer
- Hacker News 讨论:https://news.ycombinator.com/item?id=50233779